장기 기억 증강하기
핵심 요약
저자가 간격 반복 앱 Anki를 써 오며 얻은 관찰을 정리하고, 기억이 이해와 창의성에 얼마나 중요한지 되묻는 에세이예요.
- 기억은 선택의 문제가 된다: 복습 간격이 점점 늘어나서, 저자의 추산으로는 카드 한 장을 20년 동안 기억하는 데 드는 복습 시간이 모두 합쳐 4~7분 정도예요.
- 논문 읽기의 도구: 낯선 분야의 논문을 깊이 읽을 때도, 얕게 훑을 때도, 한 분야의 문헌 전체를 엮어 읽을 때도 Anki가 이해를 쌓고 붙들어 줘요.
- 질문은 원자적으로: 질문 하나에 아이디어 하나만 담고, 개인적인 창작 프로젝트에 이어서 쓸 때 Anki가 훨씬 잘 작동해요.
- 기억은 이해의 바탕: 전문가의 실력은 머릿속에 쌓아 둔 고차원 “청크”에서 나오는 것으로 보이고, 저자는 새 분야를 이해하는 데 가장 큰 장벽이 흔히 기본을 기억하는 일이라고 봐요.
- 인간 증강이라는 분야: 저자는 인지과학의 지식을 받아들이되 과감한 설계로 시스템을 만들어 내는 별도의 분야가 필요하다고 봐요.
1920년대 중반 어느 날, 모스크바의 신문기자 솔로몬 셰레셰프스키(Solomon Shereshevsky)가 심리학자 알렉산드르 루리야(Alexander Luria)의 실험실을 찾아왔어요. 신문사 상사가 보니 셰레셰프스키는 메모를 전혀 하지 않는데도 들은 말을 어째서인지 전부 기억하고 있었어요. 그래서 상사는 전문가에게 기억력을 한번 검사받아 보라고 권했죠.
루리야는 셰레셰프스키의 기억력을 검사하기 시작했어요. 처음에는 짧은 단어 열이나 숫자 열 같은 간단한 검사부터 했어요. 셰레셰프스키가 이를 쉽게 기억해 내자 루리야는 열의 길이를 차츰 늘렸어요. 하지만 아무리 길어져도 셰레셰프스키는 그대로 되읊었어요. 여기에 매료된 루리야는 이후 30년 동안 셰레셰프스키의 기억을 연구했어요. 연구를 정리한 책 『모든 것을 기억하는 남자』 (The Mind of a Mnemonist, 1968)에서 루리야는 이렇게 썼어요.
S.의 기억은 용량에도, 남긴 흔적의 지속성에도 한계가 없는 듯했다. 실험해 보니 그는 아무리 긴 단어 열이라도 어려움 없이 재현했다. 처음 제시받은 때가 일주일 전이든, 한 달 전이든, 1년 전이든, 심지어 여러 해 전이든 마찬가지였다. 실제로 기억 유지를 검사하려고 설계한 실험 가운데 일부는 그가 처음 단어를 회상했던 세션으로부터 15~16년이 지나서 (아무 예고 없이) 이루어졌다. 그런데도 결과는 언제나 성공이었다.
이런 이야기는 흥미로워요. 기억은 생각의 바탕이고, 완벽한 기억력이라는 발상은 매혹적이에요. 그런데 한편으로는 자기 기억력에 대해 복잡한 감정을 품은 사람도 많아요. “저는 기억력이 별로 좋지 않아요”라는 말을 저는 자주 들었어요. 쑥스러워하며 하는 사람도, 미안해하며 하는 사람도, 때로는 오히려 당당하게 하는 사람도 있었죠.
기억이 생각에서 이토록 큰 자리를 차지하니, 컴퓨터를 도구 삼아 기억력을 높일 수 있을지 궁금해지는 건 자연스러워요. 알고 보니 이 질문은 파고들수록 좋은 아이디어가 쏟아지는 질문이었고, 그렇게 파고든 끝에 컴퓨팅 역사에서 손꼽히게 중요한 비전 문서가 여럿 나왔어요. 초기 사례로 버니바 부시(Vannevar Bush)가 1945년에 제안한 기계식 기억 확장 장치, 메멕스 (memex)가 있어요1. 부시는 이렇게 썼어요.
메멕스는 개인이 자신의 모든 책과 기록, 통신을 저장해 두는 장치로, 기계화되어 있어 아주 빠르고 유연하게 찾아볼 수 있다. 메멕스는 그의 기억을 크게 넓혀 주는 내밀한 보완물이다.
메멕스 비전은 이후 많은 컴퓨터 선구자에게 영감을 주었어요. 더글러스 엥겔바트(Douglas Engelbart)의 인간 지능 증강 구상, 테드 넬슨(Ted Nelson)의 하이퍼텍스트 구상, 그리고 간접적으로는 팀 버너스리(Tim Berners-Lee)의 월드 와이드 웹 구상도 그 영향을 받았어요2. 버너스리는 웹을 제안하는 글에서, 자신이 몸담은 조직(입자물리학 연구 기관 CERN)이 집단적인 기관 기억을 갖춰야 한다며 그 필요를 이렇게 설명해요.
조직과 함께, 그리고 그 정보가 기술하는 프로젝트와 함께 자라고 진화할 수 있는 정보 저장고를 구축하는 것.
이는 컴퓨터로 인간의 기억을 증강하려 한 수많은 시도 가운데 몇 가지일 뿐이에요. 메멕스에서 웹, 위키, org-mode, 제너두 프로젝트(Project Xanadu), 그리고 한 사람이 하는 모든 생각을 지도로 그리려는 시도에 이르기까지, 기억 증강은 컴퓨팅에서 지극히 많은 것을 낳은 비전이었어요.
이 글에서는 개인 기억 시스템 (personal memory system), 즉 한 사람의 장기 기억 (long-term memory)을 향상하도록 설계한 시스템을 살펴봐요. 1부에서는 그런 시스템 가운데 하나인 Anki를 써 온 제 경험을 이야기할게요. 앞으로 보겠지만 Anki로는 거의 무엇이든 기억할 수 있어요. 다시 말해 Anki를 쓰면 기억은 우연에 맡겨 두는 들쭉날쭉한 일이 아니라 선택의 문제가 돼요. Anki로 연구 논문과 책을 비롯해 여러 가지를 이해하는 방법을 다루고, Anki 사용의 패턴과 안티패턴도 여럿 소개할게요. Anki는 아주 단순한 프로그램이지만, Anki를 다루는 대가의 기술 (virtuoso skill)을 기를 수 있어요. 단순한 사실을 외우는 데 그치지 않고 복잡한 내용을 깊이 이해하는 것을 겨냥한 기술이에요.
2부에서는 개인 기억 시스템 전반을 다뤄요. 많은 사람이 기억이라는 인지 능력을 미심쩍게, 심지어 깔보듯 대해요. 이를테면 기계적 암기 (rote memory)를 더 고차원적인 이해보다 열등한 것처럼 말하곤 하죠. 저는 이런 관점에 반대하며, 기억이 문제 해결과 창의성의 중심에 있다고 주장할 거예요. 2부에서는 또 개인 기억 시스템을 만드는 데, 더 넓게는 인간의 인지를 증강하는 시스템을 만드는 데 인지과학이 어떤 역할을 하는지도 논의해요. 앞으로 쓸 글 「젊은 숙녀를 위한 그림 입문서를 향하여」 (Toward a Young Lady’s Illustrated Primer)T1에서는 개인 기억 시스템에 관한 아이디어를 더 소개할 예정이에요.
이 글은 형식이 좀 특이해요. 인간의 기억과 그 작동 방식을 연구하는 전통적인 인지과학 논문이 아니에요. 그렇다고 컴퓨터 시스템 설계 논문도 아니에요. 시스템 프로토타이핑이 제 주된 관심사이긴 하지만요. 오히려 이 글은 개인 기억 시스템이 어떻게 작동하는지에 관해 비공식적으로, 그때그때 얻은 관찰과 경험칙을 추려 모은 글이에요. 저는 제 시스템을 만들 준비로 이것들을 이해하고 싶었어요. 그런데 관찰을 모으다 보니 다른 사람에게도 흥미로울지 모르겠다는 생각이 들었어요. 이 글을 개인 기억 시스템을 다루는 대가의 기술을 기르도록 돕는 실용 안내서로 여겨도 무리는 없어요. 다만 그런 안내서를 쓰는 게 주목적은 아니었기 때문에, 알고 싶은 것보다 훨씬 많이 알려 주는 안내서처럼 느껴질지도 몰라요.
서론을 마무리하며, 이 글이 다루지 않는 것을 짧게 말해 둘게요. 기억의 궁전 (memory palace)이나 장소법 (method of loci) 같은 시각화 기법은 간단히만 다뤄요. 기억력을 높이는 약물 사용도, 앞으로 나올지 모를 기억 증강용 뇌-컴퓨터 인터페이스도 다루지 않아요. 모두 따로 다뤄야 할 주제예요. 하지만 앞으로 보겠지만, 정보를 어떻게 구조화하고 보여 주느냐만 가지고도 개인 기억 시스템에 관한 강력한 아이디어가 이미 여럿 나와 있어요.
• • •
1부: 거의 무엇이든 기억하는 법 — Anki 시스템
먼저 개인 기억 시스템 Anki를 써 온 제 경험부터 이야기할게요3. 앞서 말했듯 이 내용은 상당히 개인적이에요. 제가 관찰한 것과 비공식적인 경험칙을 모은 것이죠. 이 경험칙이 다른 사람에게는 맞지 않을 수도 있고, 사실 저에게 얼마나 잘 맞는지조차 제가 잘못 알고 있을지 몰라요. Anki 사용을 제대로 통제해서 연구한 것은 분명 아니에요! 일화적이고 인상에 기댄 것이긴 해도, 이런 개인 경험을 모으는 데는 가치가 있다고 생각해요. 저는 기억에 관한 인지과학 전문가가 아니니, 오류나 오해가 있다면 바로잡아 주시면 고맙겠어요.
Anki는 언뜻 보면 플래시카드를 컴퓨터로 옮겨 놓은 프로그램에 지나지 않는 것 같아요. 질문을 하나 입력하고,
거기에 맞는 답을 입력해요.
나중에 Anki가 이 카드를 복습하라고 해요. 즉 질문을 보여 주고, 답을 아는지 모르는지 물어요.
Anki가 일반 플래시카드보다 나은 점은 복습 일정을 관리해 준다는 거예요. 질문에 제대로 답하면 복습 간격이 점점 늘어나요. 하루였던 간격이 이틀, 엿새, 2주 하는 식으로 늘어나죠. 정보가 기억에 더 단단히 자리 잡을수록 복습을 덜 자주 해도 된다는 생각이에요. 하지만 한 번이라도 답을 틀리면 일정이 초기화되고, 복습 간격을 처음부터 다시 늘려 가야 해요.
컴퓨터가 복습 간격을 관리해 주면 쓸모 있는 건 분명하지만, 그렇게 대단한 일로 보이지는 않을 수도 있어요. 핵심은, 알고 보니 이 방식이 정보를 기억하는 데 훨씬 효율적이라는 거예요.
얼마나 더 효율적일까요?
이 질문에 답하려고 시간을 대략 어림해 볼게요. 저는 카드 한 장을 복습하는 데 평균 8초쯤 걸려요. 일반 플래시카드를 쓰면서 (이를테면) 일주일에 한 번 복습한다고 해 봐요. 무언가를 앞으로 20년 동안 기억하고 싶다면 20년 × 1년 52주 × 카드당 8초가 필요해요. 계산하면 카드 한 장당 총 복습 시간이 2시간을 조금 넘어요.
반면 Anki의 복습 간격은 계속 늘어나서 금세 한 달을 넘기고, 이어서 1년을 넘어요. 실제로 제 Anki 카드의 평균 복습 간격은 현재 1.2년이고, 계속 늘고 있어요. 아래 부록에서 어림해 보니, 평균적인 카드 한 장은 20년 동안 총 4~7분만 복습하면 될 거예요. 이 추정치에는 가끔 복습에 실패해서 간격이 초기화되는 경우도 반영되어 있어요. 일반 플래시카드에 드는 2시간 남짓과 비교하면 20배 넘게 아끼는 셈이에요.
그래서 저에게는 경험칙이 두 가지 있어요. 첫째, 어떤 사실을 외우는 게 앞으로 제 시간 10분을 들일 가치가 있어 보이면 외워요4. 둘째, 첫째보다 우선하는 규칙인데, 어떤 사실이 인상적이면 미래의 10분만큼 가치가 있어 보이든 말든 Anki에 넣어요. 예외를 두는 이유는 이래요. 우리가 아는 정말 중요한 것 가운데 상당수는 중요해질지 확신은 없지만 직관적으로는 중요하다고 느껴지는 것들이거든요. 그렇다고 모든 걸 외워야 한다는 뜻은 아니에요. 하지만 무엇을 외울지 고르는 안목은 기를 만해요.
Anki가 가져오는 가장 큰 변화는 기억이 더는 우연에 맡겨 두는 들쭉날쭉한 일이 아니게 된다는 점이에요. Anki를 쓰면 아주 적은 노력으로도 원하는 것을 확실히 기억할 수 있어요. 다시 말해 Anki 덕분에 기억은 선택의 문제가 돼요.
Anki를 어디에 쓸 수 있을까요? 저는 삶의 모든 영역에서 Anki를 써요. 일에서는 논문과 책에서 배우고, 강연과 학회에서 배우고, 대화에서 알게 된 흥미로운 것을 떠올리고, 일상 업무 중에 얻은 핵심 관찰을 기억하는 데 써요. 개인적으로는 가족과 사회생활에 관련된 온갖 사실, 제가 사는 도시와 여행에 관한 사실, 취미에 관한 사실을 기억하는 데 써요. 글 뒷부분에서 유용한 Anki 사용 패턴과 피해야 할 안티패턴을 소개할게요.
저는 Anki를 꾸준히 써 온 2년 반쯤 동안 카드를 1만 장 조금 넘게 만들었어요. 그 기간에는 새 카드를 거의 만들지 않은 7개월의 공백도 들어 있어요. 카드 복습을 밀리지 않고 할 때는 하루 15~20분쯤 걸려요. 이 시간이 20분을 훌쩍 넘는 일이 잦아지면 대개 카드를 너무 빨리 추가하고 있다는 뜻이니 속도를 늦춰야 해요. 아니면 카드 복습이 밀렸다는 뜻일 때도 있어요(이건 뒤에서 다룰게요).
실제로는 새 카드를 입력할 때는 데스크톱 Anki 클라이언트를, 복습할 때는 모바일 클라이언트를 써요5. 아침 커피를 사러 걸어갈 때, 줄 서서 기다릴 때, 대중교통을 탈 때 같은 틈에 Anki 카드를 복습해요. 시작할 때 마음이 어느 정도 느긋하면 복습이 명상처럼 느껴져요. 반대로 마음이 느긋하지 않으면 복습이 더 힘들고, Anki 때문에 생각이 더 이리저리 튀기도 해요.
저는 처음에 Anki를 시작하기가 어려웠어요. 아는 사람 몇이 Anki(나 비슷한 시스템)를 적극 추천해서 여러 해 동안 몇 번이나 써 보려 했지만, 매번 금방 포기했어요. 돌이켜 보면 Anki를 습관으로 만들려면 넘어야 할 장벽이 상당해요.
마침내 Anki가 제게 “자리 잡아” 습관이 된 계기는 농담 삼아 시작한 프로젝트였어요. 저는 Unix 명령줄을 제대로 익히지 못해 몇 년째 답답해하고 있었어요. 아주 기초적인 명령어밖에 몰랐거든요. 프로그래밍하는 사람에게 명령줄을 익히는 건 초능력을 얻는 것과 같으니, 잘 알아 두면 무척 좋을 것 같았어요. 그래서 재미 삼아, Anki로 Unix 명령줄에 관한 (얇은) 책 한 권을 사실상 통째로 외울 수 있을지 궁금해졌어요.
할 수 있었어요!
제가 고른 책은 오라일리 미디어(O’Reilly Media)에서 나온 대니얼 배럿(Daniel Barrett)의 『Macintosh Terminal Pocket Guide』 였어요. 책 본문 전체를 글자 그대로 외웠다는 말은 아니에요6. 하지만 책에 담긴 개념적 지식의 상당 부분과, 책에 나오는 명령어 대부분의 이름, 문법, 옵션을 외웠어요. 예외는 제가 쓸 일을 떠올릴 만한 기준점조차 없는 것들이었어요. 그래도 쓸 일을 떠올릴 수 있는 건 대부분 외웠어요. 결국 저와 관련 없어 보이는 부분은 건너뛰거나 훑어보면서 책의 60~70퍼센트쯤을 다뤘어요. 그래도 명령줄 지식이 엄청나게 늘었어요.
꽤 터무니없지만 무척 쓸모 있는 이 목표를 고른 덕분에 Anki에 큰 확신을 얻었어요. 신나는 경험이었고, 예전 같으면 배우기가 꽤 지루하고 어려웠을 것들을 Anki로 쉽게 배울 수 있다는 게 분명해졌어요. 이 확신 덕분에 이번에는 Anki 습관을 들이기가 훨씬 쉬워졌어요. 동시에 이 프로젝트로 Anki 인터페이스를 익혔고, 질문을 던지는 여러 방식을 실험해 보게 되었어요. 다시 말해 Anki를 잘 쓰는 데 필요한 기술을 기르는 데 도움이 되었어요.
Anki로 낯선 분야의 연구 논문을 꼼꼼히 읽기
연구 논문을 읽을 때, 특히 제 전문 분야 밖의 논문을 읽을 때 Anki가 큰 도움이 돼요. 어떻게 쓰는지 보여 드리려고, 알파고(AlphaGo)를 다룬 2016년 논문7을 읽은 경험을 이야기해 볼게요. 알파고는 구글 딥마인드(Google DeepMind)가 만든 컴퓨터 시스템으로, 바둑에서 세계 최정상급 기사 몇 명을 꺾었어요.
알파고가 역사상 손꼽히는 바둑 기사인 이세돌을 이긴 대국이 끝난 뒤, 저는 『콴타 매거진』(Quanta Magazine)에 이 시스템에 관한 기사를 쓰겠다고 제안했어요8. 당시 알파고는 언론의 뜨거운 화제였고, 기사들은 대개 인간적인 흥미에 초점을 맞췄어요. 알파고를 오래된 ‘인간 대 기계’ 서사의 한 장면으로 보고, 기술적인 내용은 주로 양념 삼아 조금 곁들이는 식이었죠.
저는 다른 각도에서 다루고 싶었어요. 1990년대와 2000년대의 첫 10년 동안, 저는 인간 수준이나 그 이상의 범용 인공지능은 아주, 아주 먼 이야기라고 믿었어요. 그 기간에 연구자들이 직관적인 패턴 매칭을 하는 시스템을 만드는 데 아주 더디게만 나아갔기 때문이에요. 인간의 시각과 청각, 그리고 바둑 같은 게임을 두는 능력의 바탕에 깔린 바로 그런 종류의 패턴 매칭 말이에요. AI 연구자들이 엄청나게 애썼는데도, 사람에게는 아무 힘도 들지 않는 패턴 매칭 과제 상당수가 기계에게는 여전히 불가능했어요.
이 문제들은 오랫동안 아주 느리게만 진전됐지만, 2011년 무렵부터 심층 신경망(deep neural network)이 발전하면서 속도가 붙기 시작했어요. 예를 들어 기계 시각 시스템은 형편없는 수준에서 출발해, 일부 제한된 과제에서는 사람과 견줄 만한 수준까지 빠르게 올라왔어요. 알파고가 나왔을 즈음에는 직관적인 패턴 매칭을 하는 컴퓨터 시스템을 어떻게 만들지 전혀 모른다고 말할 수 없게 됐어요. 문제를 완전히 해결하지는 못했어도 빠르게 나아가고 있었죠. 알파고는 그 흐름의 큰 부분이었고, 저는 인간의 직관을 담아내는 컴퓨터 시스템을 만든다는 이 생각을 기사에서 파고들고 싶었어요.
신이 나긴 했지만, 그런 기사를 쓰기는 어려울 터였어요. 보통의 언론 기사보다 알파고의 기술적 세부를 더 깊이 이해해야 했으니까요. 다행히 신경망에 관해서는 꽤 많이 알고 있었어요. 신경망에 관한 책을 쓴 적도 있었거든요9. 하지만 바둑에 관해서는 아무것도 몰랐고, 알파고가 쓰는 여러 아이디어의 바탕인 강화 학습(reinforcement learning)이라는 분야도 몰랐어요. 이 내용을 처음부터 배워야 했고, 좋은 기사를 쓰려면 밑바탕의 기술적 내용을 제대로 이해해야 했어요.
저는 이렇게 접근했어요.
먼저 알파고 논문 자체부터 읽었어요. 거의 훑어보듯이 빠르게 읽기 시작했죠. 내용을 빈틈없이 이해하려던 게 아니었어요. 그보다는 두 가지를 하고 있었어요. 하나는 논문에서 가장 중요한 아이디어가 무엇인지 그저 가려내는 일이었어요. 제가 공부해야 할 핵심 기법들의 이름은 무엇일까? 다른 하나는 일종의 쓸어 담기였어요. 쉽게 이해할 수 있고 분명히 도움이 될 기본 사실들을 찾아 모으는 거죠. 기본 용어나 바둑 규칙 같은 것들이요.
이 단계에서 Anki에 넣은 질문을 몇 가지 예로 들어 볼게요. “바둑판의 크기는?”, “바둑에서는 누가 먼저 두나?”, “알파고는 사람이 둔 대국의 국면을 몇 개나 학습했나?”, “알파고는 학습 데이터를 어디서 얻었나?”, “알파고가 쓴 두 가지 주요 신경망의 이름은?”
보다시피 모두 기초적인 질문이에요. 논문을 처음 한 번 훑으면서, 이따금 구글이나 위키백과를 찾아보는 정도로 아주 쉽게 얻을 수 있는 것들이죠. 게다가 이런 사실들은 하나씩 떼어 놓고 보면 익히기 쉬웠지만, 논문의 다른 내용을 더 깊이 이해하는 데에도 쓸모가 있어 보였어요.
이런 식으로 논문을 여러 번 빠르게 훑었고, 매번 조금씩 더 깊이 들어갔어요. 이 단계에서는 알파고를 완전히 이해하려는 게 아니었어요. 배경지식을 쌓으려는 거였죠. 쉽게 이해되지 않는 게 있으면 언제든 신경 쓰지 않고 그냥 넘어갔어요. 그런데 훑기를 거듭할수록 쉽게 이해되는 범위가 점점 넓어졌어요. 어느새 알파고 신경망의 입력으로 쓰이는 특징(feature)의 종류라든가, 신경망 구조에 관한 기본 사실 같은 질문을 추가하고 있더라고요.
그렇게 대여섯 번 훑은 뒤, 다시 돌아가 꼼꼼히 읽기를 시도했어요. 이번에는 알파고를 세세하게 이해하는 게 목적이었어요. 이쯤에는 배경 맥락을 상당 부분 이해한 상태여서, 꼼꼼히 읽기가 비교적 수월했어요. 아무 준비 없이 논문에 달려들 때보다는 확실히 훨씬 쉬웠죠. 오해는 마세요. 그래도 여전히 어려웠어요. 하지만 그렇게 하지 않았을 때보다는 훨씬 쉬웠어요.
알파고 논문을 한 번 꼼꼼히 읽은 뒤, 같은 방식으로 두 번째로 꼼꼼히 읽었어요. 더 많은 것이 제자리를 찾아갔어요. 이때쯤에는 알파고 시스템을 꽤 잘 이해하게 됐어요. Anki에 넣는 질문 중 상당수가 고차원적인 것이었고, 때로는 독자적인 연구 방향에 거의 닿을 듯한 질문도 있었어요. 기사에서 알파고를 다루는 부분은 자신 있게 쓸 수 있을 만큼은 분명히 이해하고 있었어요. (실제로 제 기사는 알파고 말고도 여러 시스템을 넘나들었기 때문에, 그 시스템들도 비슷한 과정으로 공부해야 했어요. 다만 그만큼 깊이 들어가지는 않았어요.) 기사를 쓰는 동안에도 질문을 계속 추가해서, 결국 모두 몇백 개를 넣었어요. 하지만 이 시점에 가장 힘든 일은 이미 끝나 있었어요.
물론 Anki 대신 평범하게 노트를 하면서 비슷한 과정으로 논문에 대한 이해를 쌓을 수도 있었을 거예요. 하지만 Anki를 쓰면 이해한 것의 상당 부분을 오래 간직하리라는 확신이 생겼어요. 1년쯤 뒤에 딥마인드가 후속 시스템인 알파고 제로와 알파제로를 다룬 논문을 발표했어요10. 그사이 알파고나 강화 학습에 관해서는 거의 생각하지 않았는데도, 그 후속 논문들을 쉽게 읽을 수 있었어요. 처음 알파고 논문만큼 꼼꼼히 이해하려고 하지는 않았지만, 한 시간도 안 걸려 꽤 잘 이해할 수 있었어요. 예전에 이해한 것을 상당 부분 간직하고 있었던 거예요!
반대로 처음 알파고 논문을 읽을 때 평범하게 노트를 했다면, 이해한 것이 더 빨리 증발해 버렸을 테고 나중 논문을 읽는 데에도 더 오래 걸렸을 거예요. 이렇게 Anki를 쓰면 이해한 것을 오래 간직하리라는 확신이 생겨요. 그리고 이 확신 덕분에 처음 무언가를 이해하는 일 자체가 더 즐거워져요. 하루나 일주일이면 잊어버릴 것이 아니라 오래 두고 쓸 것을 배우고 있다고 믿게 되니까요.
좋다, 그런데 이걸로 무엇을 할 것인가? … [이]제 내게는 이 모든 힘이 있다. 내가 고른 것이라면 무엇이든 결코 잊지 않고, 내가 잊도록 내버려 두지도 않는 기계 골렘이. 그렇다면 나는 무엇을 기억하기로 할 것인가? – 그원 브랜원
이 과정 전체에 며칠이 들었고, 그 시간을 몇 주에 걸쳐 나눠 썼어요. 꽤 많은 품이죠. 하지만 그 대가로 현대 심층 강화 학습(deep reinforcement learning)의 기초를 꽤 탄탄히 다질 수 있었어요. 심층 강화 학습은 엄청나게 중요한 분야로, 로봇공학에 아주 쓸모가 많고, 많은 연구자가 범용 인공지능에 이르는 데 중요한 역할을 하리라고 믿어요. 며칠의 품을 들여, 심층 강화 학습에 대해 아무것도 모르던 상태에서 이 분야 핵심 논문을 오래가는 수준으로 이해하는 데까지 왔어요. 분야 전반에서 쓰이는 기법을 여럿 활용한 논문이었죠. 물론 전문가가 되려면 아직 한참 멀었어요. 알파고에 관해 이해하지 못한 중요한 세부가 많았고, 이 분야에서 제 시스템을 직접 만들려면 훨씬 더 많은 공부가 필요했을 거예요. 하지만 이런 기초적인 이해는 더 깊은 전문성을 쌓아 올리기에 좋은 토대가 돼요.
눈여겨볼 점은 제가 알파고 논문을 제 창작 프로젝트, 곧 『콴타 매거진』에 실을 기사를 쓰기 위해 읽고 있었다는 거예요. 이게 중요해요. 저는 Anki가 어떤 개인적인 창작 프로젝트에 쓰일 때 훨씬 잘 작동한다고 느껴요.
대신 Anki를 언젠가 올 날을 대비해 지식을 비축하는 데 쓰고 싶은 유혹도 들어요. “아, 아프리카 지리를 공부해야겠어”, “제2차 세계대전을 공부해야겠어”, “[…]” 하고 생각하는 거죠. 이런 목표는 제게 지적으로는 끌리지만 정서적으로는 별로 마음이 가지 않아요. 이걸 여러 번 시도해 봤는데, 그러면 차갑고 생기 없는 Anki 질문이 만들어지기 쉬워요. 나중에 복습할 때 마음이 잘 닿지 않고, 답을 제대로, 깊이 체화하기도 어려운 질문들이요. 문제는 어쩐지 이런 것들을 공부“해야” 한다는 처음의 생각 자체에 있어요. 지적으로는 좋은 생각 같지만, 정서적 애착 (emotional commitment)이 거의 없는 거예요.
가장 흥미로운 것을 열심히 공부하라. 할 수 있는 한 가장 제멋대로, 불손하게, 독창적으로. – 리처드 파인먼(Richard Feynman)
반면 어떤 창작 프로젝트를 위해 읽을 때는 훨씬 좋은 Anki 질문을 만들어요. 질문과 답에 정서적으로 연결되기가 더 쉬워요. 그냥 그것들에 더 마음을 쓰게 되고, 그게 차이를 만들어요. 그러니 (어쩌면 가상의) 미래의 쓸모에 대비해 Anki 카드로 공부하고 싶은 유혹이 들더라도, Anki를 어떤 창작 프로젝트의 일부로 쓸 방법을 찾는 편이 더 나아요.
Anki로 논문 얕게 읽기
Anki를 활용한 제 읽기는 대부분 알파고 논문을 읽을 때보다 훨씬 얕아요. 논문 하나에 며칠을 쓰는 대신 보통 10분에서 60분 정도를 쓰고, 아주 좋은 논문이면 더 오래 쓰기도 해요. 얕게 읽기 (shallow read)에서 쓸모 있다고 느낀 패턴 몇 가지를 적어 볼게요.
앞에서 말했듯이, 이런 읽기는 대개 어떤 프로젝트의 배경 조사 과정에서 해요. 새 논문(또는 논문 묶음)을 발견하면 보통 몇 분 동안 살펴보며 가늠해 봐요. 이 논문에 제 프로젝트와 관련해 상당한 통찰이나 자극, 즉 새로운 질문, 새로운 아이디어, 새로운 방법, 새로운 결과가 들어 있을 것 같은가? 그렇다면 읽어 봐요.
그렇다고 논문의 모든 단어를 읽는다는 뜻은 아니에요. 그보다는 논문의 핵심 주장, 핵심 질문, 핵심 아이디어에 관한 질문을 Anki에 넣어요. 초록, 서론, 결론, 그림과 그림 설명에서 Anki 질문을 뽑아내면 특히 도움이 돼요. 보통 논문 하나에서 5개에서 20개 사이의 Anki 질문을 뽑아요. 5개보다 적게 뽑는 건 대개 좋지 않아요. 그러면 그 논문이 제 기억 속에서 고립된 고아처럼 남기 쉽거든요. 나중에 그 질문들에 별다른 연결감을 느끼기 어려워져요. 달리 말하면, 좋은 질문 5개를 추가할 수 없을 만큼 재미없는 논문이라면 아예 질문을 하나도 추가하지 않는 편이 대개 나아요.
이 과정의 실패 유형 (failure mode) 하나는 오해를 낳는 연구를 Anki 카드로 만드는(Ankify)11 경우예요. 많은 논문에 틀리거나 오해를 낳는 진술이 들어 있는데, 그런 내용을 기억에 새기는 건 제 발로 더 어리석어지는 셈이에요.
오해를 낳는 연구를 Anki에 넣지 않으려면 어떻게 해야 할까요?
예를 들어, 최근에 읽은 경제학자 벤저민 존스(Benjamin Jones)와 브루스 와인버그(Bruce Weinberg)의 논문12을 어떻게 Anki 카드로 만들었는지 설명해 볼게요. 과학자가 몇 살에 가장 위대한 발견을 하는지 연구한 논문이에요.
처음부터 밝혀 두자면, 저는 이 논문이 오해를 낳는다고 생각할 이유가 전혀 없어요! 그래도 조심할 가치는 있어요. 그런 조심의 예로, 제가 Anki에 추가한 질문 하나는 이랬어요. “Jones 2011은 1980~2011년 노벨 물리학상 수상자들이 수상 업적을 발견한 평균 나이를 몇 살이라고 주장하는가?”(답: 48세) 또 다른 변형 질문은 이랬어요. “1980~2011년 노벨 물리학상 수상자들이 평균 48세에 수상 업적을 발견했다고 주장한 논문은?”(답: Jones 2011) 이런 식으로요.
이렇게 물으면 주장에 단서가 붙어요. 이것은 Jones 2011이 내놓은 주장이고, 그 수치를 믿을 수 있느냐는 존스와 와인버그가 데이터를 얼마나 잘 분석했느냐에 달려 있다는 점이 분명해지죠. 사실 저는 그 분석을 꼼꼼히 들여다보지 않았으니, 그 수상자들의 평균 나이가 48세라고 사실처럼 받아들일 처지가 못 돼요. 하지만 그 논문이 48세라고 주장했다는 것은 분명한 사실이에요. 이 둘은 서로 다른 것이고, Anki에 넣기에는 뒤쪽이 더 나아요.
분석의 질이 특히 걱정되면, 그런 연구를 어렵게 만드는 요인에 관한 질문을 하나 이상 추가하기도 해요. 예를 들면 이런 질문이에요. “Jones 2011에서 논의한, 노벨상 수상자가 발견 당시 몇 살이었는지 알아내기 어려운 이유 하나는?” 좋은 답으로는 어느 논문에 노벨상 업적이 담겼는지 가려내기 어렵다는 점, 논문 출판이 때로 몇 년씩 늦어진다는 점, 업적이 여러 논문에 나뉘어 있기도 하다는 점 등이 있어요. 이런 어려움을 떠올리면, 존스와 와인버그가 허술했거나 그저 이해할 만한 실수를 했다면 그 수치가 틀릴 수도 있다는 점을 되새기게 돼요. 그런데 마침 이 논문에 대해서는 그런 문제를 그다지 걱정하지 않아요. 그래서 이런 질문은 Anki에 하나도 넣지 않았어요. 그래도 스스로를 오도하지 않도록 질문의 틀을 신중하게 짤 가치는 있어요.
논문을 읽을 때 쓸모 있는 또 다른 패턴은 그림을 Anki 카드로 만드는 거예요. 예를 들어 아래는 Jones 2011에 실린 그래프로, 물리학자가 40세까지(파란 선), 그리고 30세까지(검은 선) 수상 업적을 발견했을 확률을 보여 줘요.
제게는 그냥 이렇게만 묻는 Anki 질문이 있어요. “물리학자가 30세와 40세까지 수상 업적을 발견할 확률 곡선을 그린 Jones 2011의 그래프를 머릿속에 떠올려 보라.” 답은 위의 이미지이고, 머릿속 이미지가 대략 그 모양이면 성공으로 쳐요. 이런 질문을 추가해서 그래프를 더 깊이 다룰 수도 있어요. “Jones 2011의 물리학 수상 업적 그래프에서 40세까지 위대한 업적을 이룰 확률의 최댓값은 얼마인가 [즉, 위 그래프에서 파란 선의 가장 높은 점]?”(답: 약 0.8) 사실 이 그래프 하나로도 흥미로운 질문을 수십 개는 쉽게 만들 수 있어요. 그런 질문에 드는 시간 때문에 그렇게까지 하지는 않았어요. 그래도 그래프의 대략적인 모양은 정말 흥미로워요. 이런 그래프가 있다는 걸, 그리고 더 자세한 내용이 필요하면 어디를 찾아보면 되는지 알아 두는 것도 쓸모가 있고요.
앞에서 논문 하나를 Anki 카드로 만드는 데 보통 10분에서 60분을 쓰고, 그 시간은 논문에서 얻는 가치를 어떻게 판단하느냐에 달려 있다고 했어요. 다만 배우는 게 아주 많고 흥미롭게 느껴지면 계속 읽으면서 Anki 카드를 만들어요. 정말 좋은 자료에는 시간을 투자할 가치가 있어요. 하지만 대부분의 논문은 그렇지 않고, 금방 포화 상태에 이르러요. 더 보람 있는 읽을거리를 쉽게 찾을 수 있을 것 같으면 그쪽으로 바꾸세요. 무엇이든 끝까지 다 읽으려는 완벽주의가 역효과 나는 습관으로 굳지 않도록, 이렇게 바꾸는 연습을 의식적으로 해 둘 가치가 있어요. 논문은 거의 언제나 더 깊이 읽을 수 있지만, 그렇다고 다른 데서 더 큰 가치를 쉽게 얻을 수 없다는 뜻은 아니에요. 중요하지 않은 논문을 너무 오래 읽는 것도 실패 유형이에요.
Anki로 하는 신토피컬 독서
지금까지 Anki로 논문을 얕게 읽는 법과, 그보다 꽤 깊이 읽는 법을 이야기했어요. 그런데 어떤 의미에서는 Anki로 논문을 읽는 데서 그치지 않고, 어떤 분야나 세부 분야의 연구 문헌 전체를 “읽는” 것도 가능해요. 그 방법은 이래요.
그 토대가 수많은 논문을 얕게 읽는 것이라고 짐작할 수도 있어요. 실제로는 낯선 분야를 제대로 체득하려면 핵심 논문, 즉 알파고 논문 같은 논문을 깊이 파고들어야 해요. 중요한 논문을 깊이 파고들어 얻는 것은 어떤 하나의 사실이나 기법보다 더 중요해요. 그 분야에서 강력한 결과가 어떤 모습인지 감을 잡게 되거든요. 그 분야의 가장 건강한 규범과 기준을 흡수하는 데 도움이 돼요. 그 분야에서 좋은 질문을 던지는 법, 기법들을 엮는 법을 내면화하는 데에도 도움이 돼요. 알파고 같은 것이 왜 돌파구였는지, 그리고 그 한계가 무엇이었는지, 또 어떤 의미에서 그것이 사실은 그 분야의 자연스러운 진화였는지를 이해하기 시작해요. 이런 것들은 Anki 질문 하나하나에 따로 담기지는 않아요. 하지만 핵심 논문을 충분히 깊이 파고들면서 던지는 질문들에 모여서 담기기 시작해요.
그래서 한 분야 전체의 그림을 그리려 할 때, 저는 보통 정말 중요한 논문 하나로 시작해요. 가능하면 애초에 제가 그 분야에 관심을 갖게 만든 결과를 확립한 논문으로요. 그 논문은 알파고 논문에 대해 설명한 방식대로 꼼꼼히 읽어요. 그다음에는 그 분야의 다른 핵심 논문들도 꼼꼼히 읽어요. 이상적으로는 그 분야에서 가장 좋은 논문 5~10편을 읽어요. 그런데 그 사이사이에, 덜 중요한 (그래도 여전히 좋은) 논문을 훨씬 더 많이 얕게 읽기도 해요. 지금까지 해 본 바로는 수십 편 정도지만, 어떤 분야에서는 결국 이런 식으로 수백 편, 심지어 수천 편을 읽게 되리라 예상해요.
왜 가장 중요한 논문에만 집중하지 않느냐고 궁금할 수도 있어요. 이유 하나는 평범해요. 어떤 논문이 가장 중요한지 가려내기가 어려울 수 있거든요. 많은 논문을 얕게 읽어 두면, 알고 보니 그다지 중요하지 않은 논문을 깊이 읽느라 시간을 너무 많이 쓰지 않고도 핵심 논문을 가려내기가 한결 쉬워져요. 하지만 한 분야의 평범한 일상적 논문을 읽으면서 흡수하게 되는 문화도 있어요. 일상적인 진전이 어떤 모습인지, 그 분야의 실천이 어떤지에 대한 감각 말이에요. 그것도 가치가 있어요. 특히 그 분야가 지금 어디쯤 와 있는지 전체 그림을 쌓아 가고, 제 나름의 질문을 끌어내는 데 그래요. 실제로 나쁜 논문을 읽는 데 시간을 많이 쓰라고 권하지는 않지만, 나쁜 논문과도 좋은 대화를 나누는 건 분명히 가능해요. 자극은 뜻밖의 곳에서 찾아와요.
시간이 지나면 이것은 모티머 애들러(Mortimer Adler)와 찰스 밴 도렌(Charles van Doren)이 신토피컬 독서 (syntopic reading)T2라고 이름 붙인 것의 한 형태가 돼요13. 저는 한 문헌 전체에 대한 이해를 쌓아 가요. 무엇이 이뤄졌고, 무엇이 아직 이뤄지지 않았는지를요. 물론 문자 그대로 문헌 전체를 읽는 건 아니에요. 하지만 기능적으로는 그에 가까워요. 열린 문제들, 즉 제가 개인적으로 답을 알고 싶지만 아직 답이 나오지 않은 듯한 질문들을 찾아내기 시작해요. 가능성을 품은 듯하지만 그 의미는 아직 모르겠는 요령과 관찰도 찾아내요. 그리고 때로는 분야 전체의 맹점으로 보이는 것도 찾아내요. 이 모든 것에 관한 질문도 Anki에 넣어요. 이런 식으로 Anki는 제 창의적 연구를 뒷받침하는 매체가 돼요. 다만 애초에 창의적 작업을 염두에 두고 설계된 도구가 아니어서, 이런 매체로서는 단점도 좀 있어요. 예를 들어 연습장 같은 공간 안에서 길고 자유롭게 탐색하기에는 맞지 않아요. 그런데도 창의적 작업을 거드는 도구로 꽤 쓸 만해요.
지금까지는 제게 대체로 새로운 분야를 Anki로 배우는 법을 설명했어요. 반면 이미 잘 아는 분야에서는 호기심도, 그 분야에 대한 제 모델도 대개 이미 아주 탄탄해서 새로운 사실을 쉽게 통합할 수 있어요. 그래도 Anki가 쓸모 있긴 하지만, 가장 쓸모 있는 곳은 분명 새로운 분야예요. 영국의 위대한 수학자 존 에덴서 리틀우드(John Edensor Littlewood)는 이렇게 썼어요14.
내 관심 분야 밖의 수학을 배우려고 해 본 적이 있다. 얼마간 시간이 지나면 매번 처음부터 다시 시작해야 했다.
예전에 저는 새로운 분야를 배우려면 정서적으로 엄청난 노력이 든다고 느꼈는데, 이 말에는 그 느낌이 어느 정도 담겨 있어요. 강한 추진력이 없으면 새로운 분야의 많은 내용을 머리에 붙여 두기가 극도로 어려웠어요. Anki는 그 문제를 상당 부분 해결해 줘요. 어떤 의미에서 Anki는 정서적 보철물이에요. 이해에 이르는 데 필요한 추진력을 실제로 만들어 내도록 돕거든요. 그 일을 전부 해 주지는 않아요. 앞에서 말했듯이 그런 추진력을 만들려면 창의적 프로젝트나 저에게 기대는 사람들처럼 다른 약속이 있는 게 큰 도움이 돼요. 그래도 Anki 덕분에, 새로운 분야를 깊이 읽어 보기로 그냥 결정하기만 하면 배운 것의 상당 부분을 기억하고 이해할 수 있다는 자신감이 생겨요. 지금까지 시도해 본 개념적 이해의 모든 영역에서 이 방법이 통했어요15.
이렇게 읽으면서 생긴 뜻밖의 결과 하나는 읽기가 훨씬 더 즐거워졌다는 거예요. 저는 늘 읽기를 좋아했지만, 어렵고 새로운 분야에 처음 발을 들일 때는 정말 고역일 때가 있었고, 과연 그 분야에 제대로 들어갈 수 있을지 하는 의심에 자주 시달렸어요. 그리고 그 의심 탓에 성공할 가능성도 낮아졌어요. 이제는 새로운 분야에 들어가도 좋고 비교적 깊은 이해에 금방 이를 수 있고, 그 이해가 오래가리라는 자신감이 있어요. 그 자신감 덕분에 읽기가 한층 더 즐거워져요16.
Anki 사용의 다른 패턴들
기술 논문을 읽는 데 Anki를 쓰는 방법을 살펴봤으니, 이제 일반적인 사용 패턴으로 돌아가 볼게요17. 이 절에는 내용이 많아서, 처음 읽을 때는 훑어보면서 가장 눈길이 가는 항목에 집중해도 좋아요.
Anki 질문과 답은 대부분 최대한 원자적으로 만드세요: 질문과 답이 각각 아이디어 하나만 담아야 한다는 뜻이에요. 예를 들어 Unix 명령줄을 배울 때 저는 이런 질문을 넣었어요. “linkname에서 filename으로 가는 소프트 링크는 어떻게 만드는가?” 답은 “ln -s filename linkname”이었죠. 안타깝게도 저는 이 질문을 번번이 틀렸어요.
해결책은 질문을 두 조각으로 나누는 리팩터링 (refactoring)이었어요. 한 조각은 “Unix 소프트 링크를 만드는 기본 명령과 옵션은?”이고, 답은 “ln -s …”예요. 다른 조각은 “Unix 소프트 링크를 만들 때 linkname과 filename은 어떤 순서로 쓰는가?”이고, 답은 “filename linkname”이에요.
질문을 더 원자적인 조각으로 나누자, 번번이 틀리던 질문 하나가 번번이 맞히는 질문 둘이 됐어요18. 무엇보다, 실제로 Unix 소프트 링크를 만들어야 할 때 어떻게 하는지 알게 됐어요.
왜 이런 효과가 나는지는 잘 모르겠어요. 부분적으로는 초점의 문제가 아닐까 싶어요. 합쳐진 질문을 틀렸을 때는 정확히 어디서 틀렸는지가 흐릿할 때가 많았어요. 그러다 보니 실수에 초점을 날카롭게 맞추지 못했고, 실패에서 배우는 것도 그만큼 적었죠. 원자적 질문 (atomic question)을 틀리면 어디에 집중해야 할지 머리가 정확히 알아요.
대체로 Anki 질문을 더 원자적으로 쪼개면 얻는 게 상당할 때가 많아요. 질문을 리팩터링하는 강력한 패턴이에요.
그렇다고 원래 질문을 어떤 형태로든 남겨 두지 말라는 뜻은 아니에요. 저는 여전히 Unix에서 소프트 링크를 만드는 법을 알고 싶으니, 원래 질문도 Anki에 남겨 둘 만해요. 다만 이제 그 질문은 통합 질문 (integrative question)이 돼서, 단순한 원자적 사실에서 더 복잡한 아이디어로 쌓아 올라가는 질문 위계의 한 부분이 돼요.
덧붙이자면, 질문이 원자적이라고 해서 꽤 복잡하고 고차원적인 개념을 다룰 수 없다는 뜻은 아니에요. 일반 상대성이론에서 가져온 이런 질문을 생각해 보세요. “로버트슨-워커 계량(Robertson-Walker metric)에서 dr2 항은 무엇인가?” 답: dr2/(1-kr^2). 일반 상대성이론을 공부하지 않았다면 이 질문은 꽤 알쏭달쏭해 보일 거예요. 로버트슨-워커 계량이 무엇인지, dr2가 무슨 뜻인지, k가 무슨 뜻인지 등을 안다고 전제하는, 정교한 통합 질문이니까요. 하지만 그런 배경지식을 갖췄다는 조건에서는 상당히 원자적인 질문과 답이에요.
Anki를 이렇게 쓰면 좋은 점 하나는, 무엇이든 원자적 질문으로 쪼개는 습관이 든다는 거예요. 그러면 배운 것들이 저마다 뚜렷하게 결정화돼요. 저는 개인적으로 그 결정화가 만족스러운데, 그 이유는 (아이러니하게도) 말로 표현하기가 어려워요. 하지만 실질적인 이점 하나는, 나중에 그 원자적 아이디어들을 처음에는 예상하지 못한 방식으로 엮을 수 있을 때가 많다는 거예요. 그것만으로도 충분히 수고할 가치가 있어요.
Anki 사용은 길러 나가야 할 대가의 기술로 생각하는 게 가장 좋아요: Anki는 아주 단순한 프로그램이에요. 텍스트나 다른 미디어를 입력하면, 사용자의 응답에 따라 정해지는 일정대로 그 미디어를 보여 줄 뿐이죠. 이렇게 단순한데도 엄청나게 강력한 도구예요. 그리고 다른 많은 도구처럼 잘 쓰려면 기술이 필요해요. Anki를 대가의 경지까지 갈고닦을 수 있는 기술로 여기고, 그 경지를 향해 계속 실력을 끌어올리려 애쓸 만해요.
Anki는 단순한 사실을 외우는 도구에 그치지 않아요. 거의 무엇이든 이해하는 도구예요. 흔한 오해 하나는 Anki가 어휘나 기본 정의처럼 단순한 날것의 사실을 외우는 데만 쓰인다는 거예요. 하지만 앞에서 봤듯이 Anki는 훨씬 더 높은 수준의 이해에도 쓸 수 있어요. 알파고에 관한 제 질문은 “바둑판은 얼마나 큰가?” 같은 단순한 질문에서 시작해서, 알파고 시스템의 설계에 관한 고차원적인 개념 질문으로 끝났어요. 알파고가 훈련 데이터에서 과잉 일반화하지 않은 방법이나 합성곱 신경망의 한계 같은 주제였죠.
Anki를 대가의 기술로 기르는 일에는, 기본적인 사실을 넘어서는 이해에도 Anki를 쓰는 능력을 키우는 것도 포함돼요. 실제로 Anki 사용법에 관해 제가 지금까지 한 (그리고 아래에서 할) 관찰 중 상당수는 결국 무언가를 이해한다는 게 무슨 뜻인지에 관한 이야기예요. 대상을 원자적 사실로 쪼개세요. 상호 연결과 통합 질문으로 풍부한 위계를 쌓으세요. 고아 질문은 넣지 마세요. 읽을거리를 대하는 패턴, 질문 유형의 패턴(과 안티패턴), 외우고 싶은 것의 종류에 관한 패턴도 있어요. Anki를 다루는 기술은 자신이 무언가를 어떻게 이해하는지에 관한 저마다의 이론이 구체적인 모습을 띤 것이고, 그 기술을 기르면 이해력도 함께 자라요. Anki의 대가가 곧 이해의 대가라고 하면 지나친 말이겠죠. 하지만 어느 정도는 맞는 말이에요.
덱은 하나만 크게 쓰세요: Anki에서는 카드를 덱과 하위 덱으로 정리할 수 있어요. 이 기능으로 복잡한 정리 체계를 만드는 사람도 있어요. 저도 예전에는 그랬지만, 점차19 덱과 하위 덱을 큰 덱 하나로 합쳤어요. 세상은 깔끔하게 분리된 구성 요소로 나뉘어 있지 않고, 저는 아주 다른 종류의 질문끼리 부딪히게 하는 게 좋다고 믿어요. 방금은 Anki가 닭고기를 몇 도까지 익혀야 하는지 묻더니, 다음에는 JavaScript API에 관해 물어요. 이렇게 섞는 게 제게 실제로 도움이 될까요? 잘 모르겠어요. 아직까지는 JavaScript로 닭고기 요리를 제어할 이유를 찾지 못했거든요. 하지만 이렇게 섞어서 해가 될 건 없다고 생각하고, 창의적인 자극이 되어 제 지식을 색다른 맥락에 적용하는 데 도움이 되기를 바라요.
고아 질문을 피하세요: 인터넷에서 글을 읽다가 알바니아 자이언트몽구스의 털 고르기 습관에 관한 훌륭한 글을 우연히 발견했다고 해 봐요. 관심이 있는 줄도 몰랐던 주제인데 알고 보니 무척 흥미로워요. 금세 질문 5~10개를 Anki 카드로 만들어요. 좋은 일이지만, 제 경험상 몇 달 뒤에는 그 질문들이 꽤 시들하게 느껴지고 자주 틀리게 될 가능성이 높아요. 그 질문들이 제 다른 관심사와 너무 동떨어져 있고, 애초에 관심을 갖게 했던 맥락도 잊어버렸기 때문이라고 생각해요.
저는 이런 질문을 고아 질문(orphan question)이라고 불러요. 제 기억 속 다른 어떤 것과도 가깝게 이어져 있지 않으니까요. Anki에 고아 질문이 몇 개 있는 건 나쁘지 않아요. 무엇이 잠깐의 관심으로 끝나고, 무엇이 제 다른 관심사와 이어진 큰 관심사로 자랄지 미리 알기는 어렵거든요. 하지만 질문 중 고아 질문의 비중이 무시하지 못할 만큼 크다면, 주요 창작 프로젝트와 관련된 질문을 Anki에 넣는 데 더 집중하고 곁가지 자료를 넣는 일은 줄여야 한다는 신호예요.
특히 피할 만한 건 외로운 고아, 즉 다른 모든 것과 거의 동떨어진 질문 하나예요. 예를 들어 새로운 주제의 글을 읽다가 특히 유용해 보이는 아이디어를 배웠다고 해 봐요. 저는 질문을 절대 하나만 넣지 않는다는 규칙을 지켜요. 적어도 둘, 가능하면 셋 이상을 넣으려고 해요. 대개 그 정도면 쓸모 있는 지식의 씨앗은 돼요. 외로운 고아 질문이면 저는 어김없이 매번 틀리고, 애초에 넣은 것 자체가 낭비가 돼요.
덱을 공유하지 마세요: 제 Anki 덱을 공유해 줄 수 있느냐는 질문을 자주 받아요. 공유하지 않아요. 아주 일찍부터 개인적인 정보를 Anki에 넣으면 매우 유용하다는 걸 깨달았거든요. 엄청나게 사적인 걸 말하는 건 아니에요. 깊고 어두운 비밀 같은 건 절대 넣지 않아요. 비밀번호처럼 보안이 필요한 것도 넣지 않고요. 하지만 아무렇게나 퍼뜨리지는 않을 것들은 좀 넣어요.
예를 들어 저에게는 절대 함께 일하지 않을 동료들의 (아주 짧은!) 목록이 있어요. 겉으로는 매력적이고 인상적인 사람들이지만, 그 사람들이 다른 사람을 함부로 대하는 걸 거듭 봤거든요. 그런 대우의 세부 사항 몇 가지를 Anki에 넣어 두면, 그 사람을 왜 피해야 하는지 또렷이 기억할 수 있어 도움이 돼요. 이런 정보는 아무렇게나 퍼뜨려도 되는 종류가 아니에요. 제가 그 사람의 행동을 잘못 해석했거나, 그 사람이 처한 맥락을 오해했을 수도 있으니까요. 하지만 제 개인적으로는 Anki에 두는 게 유용해요.
덱은 직접 만드세요: Anki 사이트에는 공유 덱이 많지만, 저는 별로 쓸모를 찾지 못했어요. 가장 중요한 이유는, Anki 카드를 만드는 일 자체가 이해하는 행위이기 때문이에요. 즉, 좋은 질문과 좋은 답을 궁리해 내는 일은 새로운 주제를 잘 이해한다는 것의 일부예요. 남이 만든 카드를 쓰면 그 이해의 상당 부분을 포기하는 셈이에요.
실제로 저는 카드를 만드는 행위가 기억에도 도움이 된다고 믿어요. 기억 연구자들은 기억을 정교하게 부호화할수록 기억이 더 강해진다는 사실을 거듭 발견했어요. 여기서 정교화 부호화 (elaborative encoding)란 본질적으로 머릿속에 만드는 연상이 얼마나 풍부한가를 뜻해요.
예를 들어 1962년이 최초의 통신 위성 텔스타(Telstar)가 궤도에 오른 해라는 걸 고립된 사실로 외우려 할 수도 있어요. 하지만 그 사실을 다른 사실과 연결하면 더 잘 기억할 수 있어요. 비교적 평범하게는, 텔스타가 소련의 첫 인공위성 스푸트니크(Sputnik)보다 고작 5년 뒤에 발사됐다는 점에 주목할 수 있어요. 우주를 통신에 활용하기까지 오래 걸리지 않은 거죠. 덜 평범하게, 즉 더 풍부하게 정교화하자면, 저는 텔스타가 ASCII가 도입되기 한 해 전에 궤도에 올랐다는 사실이 무척 흥미로워요. ASCII는 텍스트를 주고받는 최초의 현대적 디지털 표준이라고 할 만하거든요. 인류는 텍스트를 주고받는 디지털 표준보다 통신 위성을 먼저 가졌던 거예요! 이런 연결을 찾아내는 게 정교화 부호화의 한 예예요.
Anki 카드를 만드는 행위 자체가 거의 언제나 정교화 부호화의 한 형태예요. 질문을 다른 형태로도 생각해 보고, 가능한 최선의 답을 따져 보는 등의 과정을 거치게 되니까요. 저는 아주 기초적인 카드에도 이 말이 맞는다고 믿어요. 그리고 더 복잡한 카드, 즉 외울 기본 사실을 (텔스타와 ASCII의 연결처럼) 다른 아이디어와 이어 주는 카드를 만들어 서로 풍부하게 얽힌 아이디어의 그물망을 차츰 쌓아 간다면 더욱 확실히 맞는 말이 돼요.
그렇긴 해도 덱 공유에도 가치 있는 관행이 몇 가지 있어요. 예를 들어 의대생 커뮤니티 중에는 덱을 공유하고 때로는 함께 만드는 데서 가치를 찾는 곳들이 있어요20. 저도 특정 그림을 누가 그렸는지 묻는 미술 덱처럼 아주 기초적인 질문을 담은 공유 덱에서는 쓸모를 찾았어요. 하지만 더 깊은 이해를 위해 공유 덱을 쓰는 좋은 방법은 아직 찾지 못했어요.
정교화 부호화, 곧 풍부한 연상을 만드는 전략을 키우세요: 이건 사실 메타 전략, 즉 전략을 만드는 전략이에요. 정교화 부호화에 쓸 만한 간단한 전략 하나는 “같은” 질문을 여러 변형으로 만들어 두는 것이에요. 예를 들어 앞에서 제 질문 두 개를 언급했어요. “Jones 2011은 1980~2011년 노벨 물리학상 수상자들이 수상 업적을 발견한 평균 나이를 몇 살이라고 주장하는가?” 그리고 “1980~2011년 노벨 물리학상 수상자들이 평균 48세에 수상 업적을 발견했다고 주장한 논문은?” 논리로 보면 두 질문은 분명히 밀접하게 이어져 있어요. 하지만 기억이 작동하는 방식으로 보면 서로 다른 질문이고, 전혀 다른 계기에 연상을 일으켜요.
기억의 궁전 같은 기법은 어떨까요? 기억의 궁전, 장소법 같은 아이디어를 바탕으로 한 기억술이 잘 알려져 있어요21. 기억하고 싶은 내용에 시각적·공간적 연상을 풍부하게 붙이는, 정교화 부호화의 극단적인 형태예요. 조슈아 포어(Joshua Foer)가 기억술사 에드 쿡(Ed Cooke)과 나눈 대화를 옮긴 대목을 보면, 쿡이 기본 기법 하나를 이렇게 설명해요.
에드는 이어서 이름을 기억에 남게 만드는 자기 절차를 설명해 주었다. 대회의 ‘이름과 얼굴’ 종목에서 증명사진 아흔아홉 장에 딸린 이름과 성을 외울 때 썼던 방법이다. 파티나 모임에서 사람들 이름을 기억하는 데 나도 쓸 수 있다고 그는 장담했다. “요령은 사실 허무할 만큼 단순해요.” 그가 말했다. “언제나 사람 이름의 소리를 또렷하게 상상할 수 있는 무언가와 연결하는 거예요. 핵심은 머릿속에 생생한 이미지를 만들어서, 그 사람 얼굴에 대한 시각 기억을 그 사람 이름과 이어진 시각 기억에 단단히 묶어 두는 거죠. 나중에 그 사람 이름을 떠올려야 할 때, 만들어 둔 이미지가 그냥 머릿속에 다시 떠올라요… 그러니까, 음, 이름이 조시 포어라고 했죠?” 그는 한쪽 눈썹을 치켜올리고 과장된 몸짓으로 턱을 쓰다듬었다. “그럼 저는 우리가 처음 만난 대회장 밖에서 당신이 저를 놀리는(joshing)T3 모습을 떠올리고, 그 대답으로 제가 네 조각(four pieces)으로 쪼개지는 모습을 떠올릴 거예요. Four랑 Foer, 아시겠죠? 그 작은 이미지가, 적어도 저한테는, 그냥 이름보다 재미있고 머릿속에 잘 붙어 있을 거예요.”
저도 이런 기법을 시험해 봤는데, 재미는 있지만 카드 한 벌의 순서나 긴 숫자열 같은 잡다한 정보를 외우는 데 가장 쓸모 있는 것 같아요. 더 추상적인 개념에 쓰는 방법은 덜 발달한 것 같은데, 가장 깊은 이해는 그런 추상 개념에 있을 때가 많아요. 그런 의미에서 이 기법들은 오히려 이해를 방해할 수도 있어요. 그렇긴 해도, Anki 쓰는 법을 스스로 터득해야 했듯이 이 아이디어들도 제가 더 나은 활용법을 아직 못 찾았을 뿐일 수 있어요. 특히 숙련자들이 풍부한 연상을 만드는 데 쓰는 기법 몇 가지는 더 파고들 가치가 있을지도 몰라요. 포어가 어느 기억 전문가의 말을 빌려 말했듯이, “더 기억에 남는 방식으로 생각하는 법”을 익히는 건 큰 가치가 있어요.
Anki 가치의 95%는 기능의 5%에서 나와요: Anki에는 카드를 자동으로 만드는 방법, 카드에 태그를 붙이는 방법, 플러그인 생태계를 비롯해 많은 기능이 있어요. 실제로 저는 이런 기능을 거의 쓰지 않아요. 제 카드는 늘 두 종류 중 하나예요. 대부분은 단순한 질문과 답이고, 적지 않은 나머지는 클로즈 (cloze)라고 부르는, 일종의 빈칸 채우기 시험이에요. 예를 들어 좋아하는 인용문을 클로즈로 만들어 스스로 시험해요.
“개인용 컴퓨터가 정말 __라면, 그것을 쓰는 일은 실제로 __의 __을 바꿀 것이다”, __, __ (답: 새로운 매체, 문명 전체, 사고 패턴, 앨런 케이, 1989).
클로즈로 인용문이 아닌 질문도 낼 수 있어요.
애덜슨 착시는 ___ 착시라고도 불린다. (답: 체커 그림자(checker-shadow))
왜 Anki의 기능을 더 쓰지 않을까요? 이유 하나는 핵심 기능만으로도 엄청난 이득을 얻고 있다는 거예요. 게다가 이 작은 기능 묶음을 잘 쓰는 법을 익히는 데만도 노력이 많이 들었어요. 농구공과 골대는 단순한 도구지만, 그걸 잘 다루는 법을 익히는 데 평생을 쓸 수도 있어요. 마찬가지로 Anki의 기본 사용법도 엄청나게 갈고닦을 수 있어요. 그래서 저는 그 기본 기능을 잘 쓰는 법을 익히는 데 집중해 왔어요.
Anki를 써 보고는 “효율적으로” 쓰겠다며 기능을 하나라도 더 익히려고 끝없이 파고드는 사람을 많이 알아요. 대개는 1%짜리 개선을 쫓고 있어요. 그리고 그런 사람들은 결국 “너무 어렵다”며 Anki를 그만두는 일이 많은데, 그 말은 “완벽하게 쓰고 있지 못한 것 같아 불안해졌다”는 말과 같은 뜻일 때가 많아요. 안타까운 일이에요. 앞에서 이야기했듯이 Anki는 (이를테면) 평범한 플래시카드보다 20배쯤 나은 효과를 줘요. 그러니 이들은 마지막 5%, 1%, (많은 경우) 0.1%짜리 개선 몇 가지를 놓칠까 봐 걱정하다가 2,000%의 개선을 포기하는 셈이에요. 이런 끝없는 파고들기는 특히 프로그래머들이 빠지기 쉬운 것 같아요.
그래서 처음 시작하는 사람에게는 고급 기능을 하나도 쓰지 말고 플러그인도 설치하지 말라고 권해요. 한마디로, 프로그래머 특유의 효율병에 심하게 걸리지 마세요. 기본적인 질문과 답으로 Anki 쓰는 법을 익히고, 그 틀 안에서 새로운 패턴을 탐색하는 데 집중하세요. 기능을 만지작거리며 몇 시간을 보내든, 그보다 이쪽이 훨씬 도움이 될 거예요. 그다음에 Anki를 질 높게 쓰는 습관이 꾸준히 자리 잡으면, 그때 고급 기능을 실험해 봐도 돼요.
친구와 가족에 관한 사실을 Anki에 저장하기의 어려움: 저는 친구와 가족에 관한 (민감하지 않은!) 질문을 Anki에 저장하는 실험을 해 봤어요. “[내 친구]는 비건인가?” 같은 질문에는 잘 통해요. 하지만 더 까다로운 질문에서는 제 사용법이 다소 벽에 부딪혔어요. 예를 들어 새로 사귄 친구와 그 친구의 아이들 이야기를 했는데, 아이들을 직접 만난 적은 없다고 해 보죠. “[내 친구]의 첫째 아이 이름은 무엇인가?” 같은 질문을 넣을 수 있어요. 아니면 음악 이야기를 나눴다면 “[내 친구]가 좋아하는 음악가는 누구인가?”를 넣을 수도 있고요.
이런 실험은 좋은 뜻에서 나온 거예요. 하지만 이런 질문을 만들고 나면 마음이 불편할 때가 많아요. 친구에게 관심 있는 척하는 것과 너무 비슷하게 느껴지거든요. 친구의 음악 취향이나 아이들 이름을 기억한다면 그건 그 친구에게 관심이 있어서라는, 꽤 강한 사회적 규범이 있어요. 기억 보조 도구를 쓰는 건 왠지 진심이 아닌 것처럼 느껴져요. 적어도 저한테는요.
이 문제를 두고 여러 친구와 이야기해 봤어요. 대부분은 같은 말을 해 줬어요. 애초에 그렇게까지 신경 써 주는 게 고맙고, 그게 진심이 아닐까 봐 그렇게나 걱정하는 모습이 귀엽다고요. 그러니 걱정하는 게 잘못일지도 몰라요. 그래도 저는 여전히 이게 편하지 않아요. 사람들의 음식 취향처럼 덜 사적인 정보에는 Anki를 쓰고 있어요. 어쩌면 시간이 지나면서 더 사적인 사실도 저장하게 될지 모르죠. 하지만 지금은 천천히 가고 있어요.
절차 기억과 서술 기억: 사실을 기억하는 것과 과정을 숙달하는 것은 크게 달라요. 예를 들어 Anki 질문이 단서를 주면 Unix 명령어 하나를 떠올릴 수 있더라도, 그렇다고 명령줄 앞에서 그 명령어를 쓸 기회를 알아보고 거침없이 입력할 수 있는 건 아니에요. 그리고 어려운 문제를 풀려고 아는 명령어들을 새롭고 창의적인 방식으로 조합하는 건 또 다른 일이에요.
다르게 말하면, 어떤 과정을 정말로 체화하려면 Anki 카드를 복습하는 것만으로는 부족해요. 그 과정을 실제 맥락 속에서 수행해야 해요. 그리고 그걸로 진짜 문제를 풀어야 해요.
그렇긴 해도, 저는 이 전이 과정이 비교적 쉬웠어요. 명령줄은 자주 쓰다 보니, Anki에 넣어 둔 명령줄 지식을 실제로 활용할 기회가 충분해요. 시간이 지나면서 그 서술 (declarative) 지식은 제가 맥락 속에서 일상적으로 쓰는 절차 (procedural) 지식이 되어 가고 있어요. 그래도 전이가 언제 잘 되고 언제 안 되는지 더 잘 이해하면 좋겠어요. 더 좋은 건 제 실제 작업 환경에 통합된 기억 시스템일 거예요. 예를 들어 실제 명령줄 앞에 저를 앉혀 놓고 Unix 명령어를 물어볼 수도 있겠죠. 아니면 명령줄 앞에서 더 높은 수준의 문제를 풀게 할 수도 있고요.
이런 방향으로 실험을 하나 해 봤어요. Anki 카드를 복습하면서 명령어를 입력하는 동작을 흉내 내는 거였죠. 하지만 제 주관적인 인상으로는 그다지 효과가 없었고, 하기도 꽤 번거로웠어요. 그래서 그만뒀어요.
“이름은 중요하지 않다”를 넘어서기: 저는 이론물리학을 공부했어요. 물리학계에는 리처드 파인먼이 들려준 유명한 이야기가 있어요. 사물의 이름을 아는 건 별 가치가 없다고 일축하는 이야기죠. 어린 시절 파인먼은 모르는 게 없다는 듯 구는 아이와 들판에서 놀고 있었어요. 파인먼의 말로는 이런 일이 있었어요22.
한 아이가 내게 말했다. “저 새 보여? 저게 무슨 새게?”
나는 말했다. “무슨 새인지 전혀 모르겠는데.”
그 아이가 말했다. “갈색목개똥지빠귀야. 너희 아버지는 너한테 아무것도 안 가르쳐 주시는구나!”
하지만 사실은 정반대였다. 아버지는 이미 내게 가르쳐 주셨다. “저 새 보이니?” 아버지가 말씀하셨다. “저건 스펜서휘파람새란다.” (아버지가 진짜 이름을 모른다는 걸 나는 알았다.) “그런데 이탈리아어로는 Chutto Lapittida야. 포르투갈어로는 Bom da Peida고… 세상 모든 언어로 저 새 이름을 알 수는 있겠지만, 다 알고 나도 저 새에 대해서는 아무것도 모르는 거란다! 그저 여러 곳의 사람들이 저 새를 뭐라고 부르는지만 알게 될 뿐이지. 그러니 저 새를 보면서 무엇을 하고 있는지 살펴보자꾸나. 그게 중요한 거야.” (어떤 것의 이름을 아는 것과 그것을 아는 것의 차이를 나는 아주 일찍 배웠다.)
파인먼은(또는 그의 아버지는) 이어서 진짜 지식이 무엇인지, 곧 행동을 관찰하고 그 행동의 이유를 이해하는 일 같은 것을 사려 깊게 이야기해요.
좋은 이야기예요. 하지만 너무 멀리 나갔어요. 이름은 중요해요. 그 잘난 척하던 아이가 생각한 만큼은 아닐지도 모르고, 이름이 대개 깊은 종류의 지식도 아니에요. 그래도 이름은 지식의 그물망을 쌓아 올릴 수 있게 해 주는 토대예요.
이름은 중요하지 않다는 이 상투적인 이야기를 저는 과학 교육을 받는 내내 거듭 주입받았어요. Anki를 쓰기 시작했을 때는 사물의 이름에 관한 질문을 넣는 게 좀 우스꽝스럽게 느껴졌어요. 하지만 지금은 그게 이해로 가는 길의 이른 단계라는 걸 알기에 열심히 넣어요.
Anki는 온갖 것의 이름을 익히는 데 쓸모 있지만, 저는 특히 말로 되어 있지 않은 것에 큰 도움이 된다고 느껴요. 예를 들어 미술 작품에 관한 질문을 넣어요. “화가 에밀리 헤어(Emily Hare)의 그림 Howl은 어떻게 생겼나?” 같은 질문이에요. 답은 이래요.
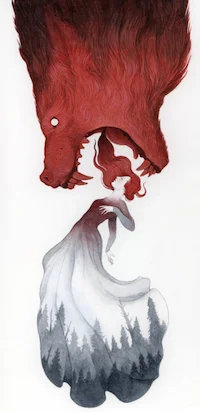
제가 이 질문을 넣은 이유는 두 가지예요. 주된 이유는 이 그림을 볼 때의 경험을 이따금 떠올리고 싶어서예요. 다른 하나는 그림과 제목을 짝지어 기억해 두려는 거예요23. 그림을 더 분석적으로, 이를테면 색 그러데이션을 영리하게 쓴 방식에 대해 생각해 보고 싶다면 더 자세한 질문을 추가할 수도 있어요. 하지만 저는 이 이미지를 볼 때의 경험을 기억에 새겨 두는 것만으로도 꽤 만족해요.
뒤처지면 어떻게 하나요? 카드가 밀리기 시작하면 Anki가 버거워져요. 하루나 이틀, 아니면 오십 일을 건너뛰면 카드가 쌓이기 시작해요. 돌아와 보니 하루에 복습할 카드가 500장이라면 겁이 나죠. 더 나쁜 건, Anki 습관을 놓아 버리면 아주 멀리 뒤처질 수 있다는 거예요. 저는 7개월 동안 Anki를 거의 쓰지 않았는데, 돌아와 보니 밀린 카드가 수천 장이었어요.
다행히 따라잡기가 그리 어렵지는 않았어요. 하루 할당량을 조금씩 늘려 가며(100장, 150장, 200장, 250장, 마침내 300장) 정해 두고, 몇 주 동안 날마다 그만큼씩 해치워서 결국 따라잡았어요.
아주 어렵지는 않았지만, 꽤 기운 빠지고 의욕이 꺾이는 일이었어요. 넘치는 카드를 앞으로 몇 주 일정에 나눠 주는 “따라잡기” 기능이 Anki에 있으면 좋겠지만, 없어요. 어쨌든 함정이긴 해도 해결하기가 그리 어렵지는 않아요.
API, 책, 영상, 세미나, 대화, 웹, 행사, 장소에 Anki 쓰기: 앞서 논문을 Anki 카드로 만드는 일에 관해 한 이야기는 거의 다 다른 자료에도 들어맞아요. 몇 가지 팁을 적어 볼게요. API 이야기는 부록으로 따로 뺐으니, 관심이 있다면 아래에서 읽어 보세요.
세미나나 동료와 나누는 대화에는 Anki 할당량을 정해 두는 게 뜻밖에 큰 도움이 돼요. 예를 들어 세미나에서는 Anki에 넣을 좋은 질문을 적어도 세 개 찾으려고 해요. 길게 이어지는 대화라면 적어도 하나요. 할당량을 정해 두면 더 집중하게 되더라고요. 특히 세미나에서 그래요. (일대일 대화에서는 애초에 집중하기가 훨씬 쉬워요.)
영상, 행사, 장소에는 좀 더 되는대로예요. 이를테면 나들이를 다녀오거나 새 식당에 가 본 뒤에, 그 경험을 기억하도록 질문 3~5개를 체계적으로 Anki에 넣으면 좋겠죠. 가끔은 그렇게 해요. 하지만 그렇게 체계적으로 하지는 못했어요.
논문과 책은 읽으면서 그때그때 Anki 카드로 만드는 편이에요. 세미나나 대화 같은 자리에서는 그 경험에 푹 빠져 있는 쪽이 좋아요. Anki를 꺼내는 대신, Anki에 넣고 싶은 것을 머릿속에(또는 종이에) 재빨리 적어 두었다가 나중에 입력해요. 여기에는 어느 정도 절제가 필요해요. 할당량을 작게 잡는 이유 하나도 그래서예요. 그래야 나중에 수십 개가 아니라 몇 개만 입력하면 되니까요.
책에는 주의할 점이 하나 있어요. 책 한 권을 다 읽는 건 큰일인데, Anki 질문을 수시로 추가하다 보면 속도가 크게 느려질 수 있어요. 얼마나 Anki에 넣을지 정할 때 이 점을 염두에 둘 만해요. 좋은 내용이 워낙 빽빽해서 시간을 들여 질문을 잔뜩 추가할 가치가 있는 책도 있어요. 하지만 눈에 띄는 대로 아무 생각 없이 전부 Anki에 넣는 건 나쁜 습관이고, 저도 가끔 그 습관에 빠지곤 했어요.
무엇을 Anki에 넣을지는 사소한 선택이 아니에요. 장기 목표에 도움이 되는 것을 넣으세요. 우리는 어느 정도 우리가 기억하는 바로 그것이 되니, 무엇을 기억할지 신중해야 해요24. 이건 언제나 맞는 말이지만, Anki를 쓰면 특히 더 그래요.
그렇긴 해도 재미있는 패턴이 하나 있어요. Anki를 쓰기 전에 책을 읽으며 적어 둔 옛 노트로 돌아가 그것을 Anki 카드로 만드는 거예요. 대개 금방 할 수 있고, 지금은 거의 잊어버린 책들에 들인 시간에서 더 많은 것을 돌려받게 해 줘요25.
아직 답을 찾지 못한 문제는 창작 프로젝트를 위한 노트 작성과 Anki를 어떻게 통합할지예요. 노트를 Anki로 대신할 수는 없어요. 너무 느리고, 많은 경우 장기 기억을 잘못 쓰는 일이니까요. 반면 중요한 항목에 Anki를 쓰면 이점이 많아요. 기억을 막힘없이 꺼내 쓸 수 있다는 것이 수많은 창의적 사고의 토대거든요. 실제로는 어떤 것은 노트로, 어떤 것은 Anki 질문으로, 또 어떤 것은 둘 다로, 본능적으로 체계 없이 처리하게 돼요. 전체적으로는 그럭저럭 돌아가지만, 좀 더 체계적으로 생각하고 실험해 보면 훨씬 나아질 수 있겠다는 느낌이 들어요. 문제의 일부는 애초에 제게 변변한 노트 작성 체계가 없다는 거예요! 그쪽을 더 다듬으면 전체가 훨씬 나아지리라 짐작해요. 그래도 그럭저럭 돌아가긴 해요.
연상적 사고의 속도는 창의적인 작업에서 중요하다고 나는 믿는다. – 존 리틀우드
예/아니요 패턴을 피하세요: 제가 가끔 빠지는 나쁜 습관 하나는 답이 예/아니요인 Anki 질문을 잔뜩 만드는 거예요. 예를 들어 머신러닝의 그래프 모델 (graphical model)을 공부할 때 추가한, 썩 좋지 않은 질문이 이거예요.
대부분의 그래프 모델에서 분할 함수(partition function)를 계산하는 일은 다루기 어려운(intractable) 문제인가?
답은 “예”예요. 그 자체로는 괜찮아요. 하지만 질문에 담긴 개념을 더 풀어 보면 이해에 도움이 될 거예요. 어떤 그래프 모델에서 분할 함수를 다룰 수 있는지(tractable) 묻는 질문을 추가할 수 있을까요? 분할 함수를 다루기 어려운 그래프 모델의 예를 들 수 있을까요? 애초에 분할 함수 계산이 다루기 어렵다는 건 무슨 뜻일까요? 예/아니요 질문은 적어도 질문 리팩터링의 유력한 후보로 봐야 해요26.
외부 기억 보조 도구로 충분하지 않나요? Anki 같은 시스템에 흔히 나오는 비판 하나는 구글, 위키, 노트 같은 외부 기억 장치로 충분하다는 거예요. 물론 이런 시스템도 잘 쓰면 Anki를 보완하는 데 아주 유용해요. 하지만 창의적인 작업과 문제 해결에는 이해를 내면화해 두는 데서만 얻을 수 있는 특별한 무언가가 있어요. 내면화해 두면 연상적 사고가 빨라지고, 수많은 아이디어 조합을 빠르게 시험해 보고, 패턴을 직관적으로 알아챌 수 있어요. 정보를 매번 힘들게 찾아봐야 한다면 불가능한 방식으로요.
생각에서는 유창함이 중요해요. 앨런 케이(Alan Kay)와 아델 골드버그(Adele Goldberg)는 “음을 불고 나서 그 소리를 듣기까지 1초가 걸리는!” 플루트라는 사고 실험을 제안했어요27. 두 사람이 지적하듯 이는 “터무니없는” 일이죠. 마찬가지로, 어떤 종류의 생각은 관련된 이해를 모두 머릿속에 담고 있을 때 훨씬 떠올리기 쉬워요. 그런 생각을 하는 데 Anki는 더없이 귀한 도구예요.
개인 기억 시스템이 그렇게 좋다면, 왜 더 널리 쓰이지 않을까요? 이 질문은 두 경제학자에 관한 오래된 농담과 비슷해요. 둘이 함께 길을 걷다가 한 사람이 20달러 지폐를 발견하고 말해요. “봐! 땅에 20달러가 떨어져 있어!” 다른 사람이 대답하죠. “그럴 리 없어! 정말 있었다면 누가 벌써 주워 갔겠지.”
이 비유는 부분적으로만 들어맞아요. 사실 Anki는 땅에 떨어진 20달러 지폐가 끝없이 공급되는 것처럼 보이거든요. 그러니 왜 더 널리 쓰이지 않는지 묻는 것도 당연해요. 관련 연구 문헌에서 손꼽히게 많이 인용되는 논문 하나28가 바로 이런 아이디어가 왜 교육에서 더 널리 쓰이지 않는지를 다뤄요. 1988년에 쓰였지만, 그 논문의 관찰 중 상당수가 오늘날에도 여전히 들어맞아요.
제 개인적인 짐작으로는 주된 요인이 세 가지예요.
- 기억에 관한 실험 연구에서 사람들은 Anki와 비슷한 방식으로 공부를 분산했을 때 얻는 이득을 일관되게 과소평가해요. 대신 막판 벼락치기를 선호하고 그쪽이 더 좋은 결과를 낸다고 믿어요. 그렇지 않다는 연구가 많은데도요.
- 심리학자 로버트 비요크(Robert Bjork)는 “바람직한 어려움의 원리 (principle of desirable difficulty)”를 제안했어요29. 기억은 잊어버리기 직전에 시험받을 때 가장 강해진다는 생각이에요. 이는 효율적인 기억 시스템이라면 본질적으로 쓰기에 어느 정도 어려울 수밖에 없다는 뜻이기도 해요. 사람은 어려운 일 앞에서 마음이 복잡해져서, 동기가 강하지 않으면 대개 피하고 싶어 해요(동기가 강하면 오히려 그 어려움이 즐거워지기도 하고요).
- Anki 같은 시스템은 잘 쓰기는 어렵고, 잘못 쓰기는 쉬워요.
이런 문제의 일부나 전부를 극복할 수 있는 시스템을 개발한다는 건 생각해 볼 만한 흥미로운 주제예요.
• • •
2부: 개인 기억 시스템을 더 넓게 보기
이 에세이의 1부에서는 특정한 개인 기억 시스템인 Anki를 제 개인적인 경험이라는 렌즈로 살펴봤어요. 더 짧은 2부에서는 개인 기억 시스템에 관한 더 넓은 질문 두 가지를 다룰 거예요. 기억은 인지 능력으로서 얼마나 중요할까? 그리고 개인 기억 시스템을 만드는 데 인지과학은 어떤 역할을 할까?
장기 기억은 대체 얼마나 중요할까?
장기 기억은 가끔 폄하돼요. 특히 교실에서 “기계적 암기”를 깎아내리는 사람이 흔해요. 어떤 수업을 그만뒀다는 이야기를 많은 사람에게서 들었는데(유기화학인 경우가 많아요), 이유는 “그냥 사실을 잔뜩 늘어놓은 것뿐이라서, 이해가 더 필요한 걸 하고 싶었다”는 거였어요.
나쁜 수업이나, 유기화학을 흔히 가르치는 방식을 옹호할 생각은 없어요. 하지만 기억의 중요성을 과소평가하는 건 잘못이에요. 저도 한때는 기억이 별로 중요하지 않다는 그런 상투적인 말을 믿었어요. 하지만 이제는 기억이 우리 인지의 토대라고 믿어요.
이렇게 생각이 바뀐 주된 이유는 두 가지예요. 하나는 개인적인 경험이고, 다른 하나는 인지과학의 증거예요.
개인적인 경험부터 이야기할게요.
여러 해 동안 저는 양자역학 같은 기술적인 주제를 배우는 사람들을 자주 도왔어요. 시간이 지나면 사람들이 어디서 막히는지 패턴이 보이기 시작해요. 흔한 패턴 하나는 본인은 난해하고 복잡한 문제에서 막혔다고 생각한다는 거예요. 하지만 파고들어 보면 기본적인 표기법과 용어를 어려워하고 있다는 게 드러나요. 단어나 표기 세 개 중 하나가 불분명한 상태로 양자역학을 이해하기란 어려워요! 문장 하나하나가 고투예요.
마치 프랑스어 단어를 200개밖에 모르면서 프랑스어로 아름다운 소네트를 지으려는 것과 같아요. 답답해하면서, 좋은 주제나 인상적인 정서와 이미지 같은 걸 찾기 어려운 게 문제라고 생각하죠. 하지만 진짜 문제는 시를 지을 단어가 200개뿐이라는 거예요.
저는 다소 신앙처럼 이렇게 믿고 있었어요. 사람들이 기본을 기억하는 데 더 집중하고 “어려운” 고차원 문제를 덜 걱정하면, 고차원 문제는 저절로 풀린다고요.
하지만 다른 사람들에 대해서는 이렇게 굳게 확신하면서도, 그게 제게도 해당한다는 건 깨닫지 못했어요. 그리고 제게 얼마나 강하게 해당하는지는 전혀 몰랐어요. Anki로 새 분야의 논문을 읽으면서 이 착각이 깨졌어요. Anki 덕분에 그런 주제를 배우기가 얼마나 쉬워졌는지, 거의 당혹스러울 정도였어요. 이제는 이해를 가로막는 가장 큰 단일 장벽이 기본을 기억하는 일인 경우가 많다고 믿어요. 그 장벽을 넘게 해 주는 Anki 같은 시스템이 있다면, 새 분야를 읽어 들어가기가 훨씬, 훨씬 쉬워질 거예요.
Anki 덕분에 새로운 기술 분야를 배우기가 얼마나 쉬워졌는지 겪고 나니, 기억이 얼마나 중요한지 몸으로 훨씬 깊이 실감하게 됐어요.
기억이 인지에서 핵심 역할을 한다는 걸 보여 주는 결과는 인지과학에도 많아요.
인상적인 연구 흐름 하나는 아드리안 더 흐로트(Adriaan de Groot)와 허버트 사이먼(Herbert Simon)이 (각자 따로) 수행한 것으로, 사람들이 어떻게 전문성을 얻는지를 특히 체스에 초점을 맞춰 연구했어요30. 이들은 세계 정상급 체스 전문가가 초보자와 다르게 판을 본다는 것을 알아냈어요. 초보자는 “여기 폰, 저기 룩” 하는 식으로 개별 말의 나열을 봐요. 반면 마스터는 훨씬 정교한 “청크 (chunk)”를 봤어요. 하나의 단위로 알아보는 말들의 조합으로, 개별 말보다 높은 추상 수준에서 추론할 수 있는 것이었죠.
사이먼은 체스 마스터가 훈련하면서 이런 청크를 25,000개에서 100,000개 정도 익히며, 청크를 익히는 것이 일류 체스 선수가 되는 핵심 요소라고 추정했어요. 이런 선수들은 정말로 초보자와는 아주 다르게 체스 국면을 봐요.
이런 청크를 알아보고 추론하는 법을 익히는 게 전문성을 키우는 데 왜 그렇게 도움이 될까요? 추측에 기댄 비공식적인 모델을 하나 소개할게요. 제가 아는 한 인지과학자들이 검증한 적은 없으니 너무 진지하게 받아들이지는 마세요. 체스 대신 수학을 예로 설명할게요. 수학은 초보자부터 뛰어난 직업 수학자까지 온갖 수준의 사람들과 이야기해 본 경험이 있는 분야거든요.
많은 사람이 뛰어난 수학자를 놀랄 만큼 똑똑하고 IQ가 아주 높으며 머릿속에서 아주 복잡한 개념을 다룰 수 있는 사람으로 그려요. 흔한 인식은 그 똑똑함 덕분에 아주 복잡한 개념을 다룰 수 있다는 거예요. 한마디로 더 마력 높은 엔진을 갖고 있다는 거죠.
최고의 수학자들이 대개 아주 똑똑한 건 사실이에요. 하지만 무슨 일이 일어나는지 다르게 설명할 수도 있어요. 사이먼의 말대로라면, 많은 최고 수학자는 열심히 노력해서 보통 사람보다 훨씬 많은 복잡한 수학적 청크를 내면화했다는 거예요. 그러면 우리 같은 나머지 사람에게는 아주 복잡해 보이는 수학적 상황이 그들에게는 아주 단순해 보여요. 그러니 더 많은 복잡성을 다룰 수 있다는 의미에서 마력 높은 머리를 가진 게 아니에요. 그보다는 그동안의 학습으로 청킹 능력이 좋아져서, 대부분의 사람이 복잡하게 보는 상황을 단순하게 보고, 그래서 훨씬 쉽게 추론하는 거예요.
그런데 사이먼이 체스 선수 연구에서 쓴 청크 개념은 사실 조지 밀러(George Miller)의 유명한 1956년 논문 「마법의 숫자 7, 더하기 빼기 2」 (The Magical Number Seven, Plus or Minus Two)에서 나왔어요31. 밀러는 작업 기억 (working memory)의 용량이 대략 청크 일곱 개라고 주장했어요. 실제로는 이 숫자가 사람마다 다르고, 개인의 작업 기억 용량과 일반 지적 능력(IQ) 사이에 상당한 상관관계가 있다는 것이 밝혀졌어요32. 대개 작업 기억이 좋을수록 IQ가 높고, 그 반대도 마찬가지예요.
밀러는 청크가 정확히 무엇인지 다소 모호하게 남겨 두고 이렇게 썼어요.
비트와 청크라는 용어를 대비하면, 무엇이 정보의 청크를 이루는지에 대해 우리가 그리 명확하지 않다는 사실도 두드러진다. 예를 들어 헤이스(Hayes)가 얻은 다섯 단어의 기억 범위는… 각 단어에 음소가 세 개쯤 있었으므로 15음소의 기억 범위라고 불러도 똑같이 적절했을 것이다. 직관적으로는 피험자들이 음소 15개가 아니라 단어 다섯 개를 회상하고 있었음이 분명하지만, 논리적 구분은 곧바로 드러나지 않는다. 여기서 우리가 다루는 것은 입력을 익숙한 단위, 즉 청크로 조직하거나 묶는 과정이며, 이 익숙한 단위를 형성하는 데에는 많은 학습이 들어갔다.
다시 말해 밀러의 설명에서 청크는 사실상 작업 기억의 기본 단위였어요. 그러니 사이먼과 동료들은 체스 선수의 작업 기억이 쓰는 기본 단위를 연구한 셈이에요. 그 청크가 더 복잡하다면, 선수의 작업 기억은 실질적인 용량이 더 크다는 뜻이에요. 특히 IQ는 낮지만 더 복잡한 청크를 불러올 수 있는 사람은, IQ는 높지만 내면화한 청크가 덜 복잡한 사람보다 더 복잡한 상황을 추론할 수 있을 거예요.
바꿔 말하면, 어떤 분야에서 청크를 더 많이 기억해 두는 것은 그 분야에서 IQ를 실질적으로 끌어올리는 것과 어느 정도 비슷해요.
자, 여기까지가 추측에 기댄 비공식적 모델이에요. 이 모델이 맞든 틀리든, 고차원 청크를 내면화하는 것이 전문성을 얻는 데 결정적인 부분인 것은 분명해 보여요. 하지만 그렇다고 해서 Anki 같은 시스템을 쓰면 그런 청크를 더 빨리 얻게 된다는 결론이 꼭 따라 나오지는 않아요. 장기 기억이 어떤 종류의 전문성을 얻는 데 결정적인 역할을 한다는 논증일 뿐이에요. 그래도 Anki 같은 시스템을 꾸준히 쓰면 전문가가 쓰는 고차원 청크를 얻는 속도가 빨라질 수 있다는 건 그럴듯해 보여요33. 그리고 그 청크가 이해하고, 문제를 풀고, 창조하는 능력을 비롯한 효과적인 인지의 중심에 있다는 것도요.
분산 연습
Anki는 왜 효과가 있을까요? 이 절에서는 그 바탕에 깔린 인지과학의 핵심 아이디어 가운데 하나인 분산 연습 (distributed practice)을 간단히 살펴볼게요.
파티에서 누군가를 소개받았고, 그 사람이 이름을 알려 줬다고 해 봐요. 주의를 기울이고 있었고 이름이 아주 특이하지 않다면, 20초 뒤에는 거의 틀림없이 그 이름을 기억할 거예요. 하지만 한 시간 뒤에는 잊어버렸을 가능성이 더 크고, 한 달 뒤라면 그 가능성은 더 커지죠.
즉, 기억은 쇠퇴해요. 새삼스러운 이야기는 아니에요! 하지만 독일의 위대한 심리학자 헤르만 에빙하우스(Hermann Ebbinghaus)는 기억의 쇠퇴를 체계적이고 정량적으로 연구하자는 좋은 착상을 했어요34. 특히 그는 기억이 얼마나 빨리 쇠퇴하는지, 그리고 무엇이 쇠퇴를 일으키는지에 관심이 있었어요. 이를 연구하려고 에빙하우스는 “fim”이나 “pes” 같은 무의미 음절의 나열을 외운 다음, 나중에 스스로를 시험해서 시간 간격마다 그 음절들을 얼마나 잘 기억하고 있는지 기록했어요.
에빙하우스는 어떤 항목을 정확히 기억해 낼 확률이 시간이 지나면서 (대략) 지수적으로 줄어든다는 사실을 발견했어요. 오늘날 이를 에빙하우스 망각 곡선 (Ebbinghaus forgetting curve)이라고 불러요.
곡선의 가파르기, 즉 기억이 얼마나 빨리 쇠퇴하는지는 무엇이 결정할까요? 사실 가파르기는 여러 요인에 달려 있어요. 예를 들어 더 복잡하거나 덜 익숙한 개념일수록 곡선이 더 가파를 수 있어요. 전에 들어 본 이름과 비슷하게 들리는 이름은 더 쉽게 기억할 수도 있어요. 이를테면 스즈키 하루노부(Suzuki Harunobu)보다는 리처드 해밀턴(Richard Hamilton) 같은 이름이요T4. 그러면 그런 이름은 곡선이 더 완만하겠죠. 마찬가지로 말로 된 것보다 시각적인 것이 더 기억하기 쉬울 수도 있어요. 또는 운동 기술보다 말로 된 것이 더 쉬울 수도 있고요. 그리고 기억술을 쓰거나, 그저 어떤 아이디어를 이미 아는 다른 것들과 공들여 연결하는 식으로 더 정교하게 기억하면 곡선을 완만하게 펼 수도 있어요35.
파티에서 어떤 사람을 소개받고는 20분 동안 그 이름을 전혀 떠올리지 않았다고 해 봐요. 그런데 그 사람을 다른 누군가에게 소개해야 해서 이름을 떠올려야 하는 상황이 생겼어요. 그 직후에는 이름을 기억해 낼 확률이 다시 아주 높아질 거예요. 에빙하우스의 연구에 따르면 재시험 뒤에도 확률은 지수적으로 쇠퇴하지만, 그 속도는 처음보다 느려져요. 실제로 재시험을 거듭할수록 쇠퇴는 더욱 느려지고, 여러 번의 회상으로 기억이 굳어 가면서 쇠퇴 곡선은 점점 완만해져요.
이렇게 쇠퇴 시간이 점점 늘어나는 현상이 Anki와 그 비슷한 기억 시스템을 설계하는 바탕이에요. Anki가 시험 사이의 간격을 점점 늘리는 것도 이 때문이에요.
이 현상들은 과학자들이 폭넓게 연구해 온 더 큰 아이디어 묶음의 일부예요. 이 현상들을 가리키는 관련 용어가 몇 가지 있지만, 여기서는 “분산 연습”이라는 말을 쓸게요. 시간에 걸쳐 나누어 하는 연습, 이상적으로는 기억 유지를 최대한 높이도록 설계된 방식으로 나누어 하는 연습이라는 뜻이에요. 그 반대가 벼락치기, 흔히 집중 연습 (massed practice)이라고 부르는 방식이에요. 공부를 한자리에서 몰아서 하면서 반복에 기대는 거죠.
인지를 증강하는 시스템의 설계에서 인지과학이 맡는 역할
에빙하우스 이후로 분산 연습의 여러 변형을 다룬 연구가 수천 건 나왔어요. 이 연구들 덕분에 장기 기억이 어떻게 작동하는지 많은 것을 알게 됐어요. 무엇보다 이 연구들은 분산 연습이 집중 연습보다 낫다는 것을 분명하게 보여 줘요36. 이 문헌에 뛰어들어 기억 시스템 설계의 길잡이로 삼고 싶은 마음이 들어요37. 하지만 시스템 개발의 길잡이로서 이 문헌이 어떤 한계를 지니는지도 생각해 볼 만해요.
과학자들이 분산 연습을 엄청나게 많이 연구했지만, 분산 연습에 관한 근본적인 질문 가운데 상당수는 여전히 잘 이해되지 않고 있어요.
기억이 왜 지수적으로 쇠퇴하는지, 그 모델이 언제 들어맞지 않는지 자세히 알지 못해요. 쇠퇴 속도를 무엇이 결정하는지, 그 속도가 기억의 종류마다 왜 다른지 설명하는 좋은 모델도 없어요. 회상을 거듭한 뒤에 쇠퇴가 왜 더 오래 걸리는지도 알지 못해요. 그리고 학습 사이의 간격을 어떻게 늘리는 것이 가장 좋은지도 거의 모르고요.
물론 이런 질문을 비롯한 근본적인 질문에 답하려는 부분적인 이론은 많아요. 하지만 정량적으로 예측할 수 있고 널리 받아들여지는 하나의 일반 이론은 없어요. 그런 의미에서 우리는 분산 연습에 대해 아는 것이 거의 없고, 어느 정도 온전히 이해하기까지는 아마 수십 년(어쩌면 그 이상)이 걸릴 거예요.
이 점을 구체적으로 보여 주려고 한 가지 예만 들어 볼게요. 의식적으로 무언가를 떠올리지 않았는데도 기억이 쇠퇴하기는커녕 시간이 지나면서 오히려 나아질 때가 있어요. 일상에서 이런 경험을 어렴풋이 해 봤을지도 몰라요. 심리학자 윌리엄 제임스(William James)는 이름을 밝히지 않은 어느 독일 저자의 말이라며 이렇게 농담 섞인 관찰을 남겼어요38.
우리는 겨울에 수영을 배우고 여름에 스케이트를 배운다.
실제로 바로 이런 효과가 1895년 악셀 외른(Axel Oehrn)의 연구에서 실험으로 확인됐어요39. 이후의 실험들도 이 결과를 확인했지만, 이 효과는 외우는 자료의 종류, 정확한 시간 간격을 비롯한 여러 변수에 민감하게 좌우돼요. 그런데 어떤 의미에서 이는 에빙하우스의 지수적 망각 곡선과 모순돼요. 실제로는 에빙하우스 곡선이 대체로 들어맞지만 예외가 있고, 그 예외는 보통 제한된 기간에, 아주 특정한 종류의 자료에서 나타난다고 보는 것이 꽤 괜찮은 경험칙이에요.
에빙하우스 모델에 대한 믿음을 흔들려고 이 이야기를 꺼낸 것은 아니에요. 오히려 주의하자는 뜻이에요. 기억은 복잡하고, 큰 그림에 해당하는 질문 가운데 상당수를 우리는 잘 이해하지 못하고 있으니, 어떤 모델이든 너무 믿기 전에 조심해야 해요.
그렇긴 해도 분산 연습과 에빙하우스 망각 곡선의 바탕에 있는 기본 효과는 실재하고, 크고, 많은 실험으로 확인됐어요. 외른이 발견한 것 같은 효과는 그에 비하면 덜 중요해요.
그래서 우리는 묘한 상황에 놓여 있어요. Anki 같은 시스템이 크게 도움이 되리라고 결론 내릴 만큼은 기억을 이해하고 있어요. 하지만 그런 시스템을 설계하는 데 필요한 선택 가운데 상당수는 직관과 검증되지 않은 가설에 기대어 그때그때(ad hoc) 내려야 해요. 과학 문헌의 실험들은 아직 그런 설계 선택을 정당화해 주지 못해요. 그 실험들이 대부분 애초에 그런 질문에 답하려고 설계된 것이 아니기 때문이에요. 특정한 종류의 외울 거리에만 초점을 맞추거나, 비교적 짧은 기간, 즉 몇 년이 아니라 하루나 일주일 동안의 암기에 초점을 맞추죠. 이런 연구는 기억에 관한 더 나은 이론을 세우는 데 도움이 되지만, 설계자가 시스템을 만드는 데 필요한 질문에 꼭 답해 주지는 않아요.
그래서 시스템 설계자는 비공식적인 실험과 이론처럼 다른 데서 답을 찾아야 해요. 예를 들어 Anki는 표트르 보즈니악(Piotr Wozniak)이 스스로 실험해 보며 개발한 간격 알고리즘을 써요40. 보즈니악이 논문을 여러 편 발표하긴 했지만, 비공식적인 보고서여서 일반적인 인지과학 문헌의 규범을 따르지는 않아요.
어떤 의미에서 이는 만족스럽지 않아요. 어떤 간격 일정을 써야 하는지 아주 잘 알지는 못하니까요. 하지만 시스템은 어떤 일정이든 써야 하니, 설계자는 할 수 있는 최선을 다하는 거예요. 이 방식이 순진한 접근법보다는 훨씬 잘 통할 것 같지만, 장기적으로는 인간 기억에 관한 상세한 이론에 바탕을 둔 접근법이 있으면 좋겠어요.
이에 대해 이렇게 반응할 수도 있어요. 과학적으로 설계해야 하고, 모든 설계 선택에 탄탄한 실험 증거가 있어야 한다고요. 저는 이 말이 Anki 같은 시스템의 설계자들을 비판하는 데 쓰이는 것을 들은 적이 있어요. 체계적인 과학적 이해에 뒷받침되지 않은 그때그때의 추측이 너무 많다는 거죠.
하지만 그러면 설계자들더러 어쩌라는 걸까요? 그 답들이 다 나올 때까지 50년이고 100년이고 기다리라는 걸까요? 설계를 접고 앞으로 30년 동안 기억 과학자가 되어서, 시스템을 설계하며 답해야 하는 모든 질문에 제대로 된 “과학적” 답을 내놓으라는 걸까요?
설계는 그렇게 이루어지지 않고, 그렇게 이루어져서도 안 돼요.
설계자가 모든 증거가 나올 때까지 기다린다면 아무도 무엇 하나 설계하지 못할 거예요. 실제로 필요한 것은 과감하고 상상력 넘치는 설계, 즉 많은 아이디어를 탐색하되 과학적으로 알려진 것에서 영감과 정보를 얻는(그리고 그것에 너무 얽매이지는 않는) 설계예요. 이상적으로는 여기에 훨씬 느린 피드백 루프가 함께 돌아가야 해요. 설계 선택이 기억에 관한 질문을 던지고, 그 질문이 새로운 과학 실험으로 이어지고, 그 실험이 기억에 대한 더 나은 이해로 이어지고, 그 이해가 다시 새로운 설계 방향을 제시하는 식으로요.
이런 균형을 이루기는 쉽지 않아요. 인간-컴퓨터 상호작용(HCI) 커뮤니티는 자신들이 만드는 시스템, 곧 기억만이 아니라 인간의 인지 전반을 증강하는 시스템에서 이 균형을 이루려고 애써 왔어요. 하지만 저는 그 시도가 그리 잘되지는 않았다고 생각해요. 제가 보기에 그들은 설계에서 과감함과 상상력과 포부를 많이 포기했어요41. 그렇다고 제대로 된 인지과학을 하고 있는 것도 아니에요. 마음을 상세히 이해하는 작업을 하고 있지는 않으니까요. 상상력 넘치는 설계와 인지과학 사이의 올바른 관계를 찾는 것은 증강 연구의 핵심 문제이고, 결코 간단하지 않아요.
같은 맥락에서, 인지과학자들이 직접 시스템을 만들기 시작하는 모습을 떠올려 보고 싶어지기도 해요. 그게 통할 때도 있겠지만, 대부분은 좋은 결과로 이어지지 않을 것 같아요. 효과적인 시스템은 프로토타입이라도 만들기 어려워요. 인지과학자들은 대체로 그것을 잘 해낼 기술과 설계 상상력이 부족해요.
그래서 저는 인간 증강이라는 별도의 분야가 필요하다고 생각해요. 그 분야는 인지과학에서 지식을 받아들일 거예요. 하지만 근본적으로는 설계 과학, 즉 과감하고 상상력 넘치는 설계를 지향하고 프로토타입부터 대규모 배포까지 시스템을 만들어 내는 분야가 될 거예요.
• • •
감사의 말
제가 처음 Anki에 흥미를 느낀 데는 그원 브랜원, 사샤 런디(Sasha Laundy), 데릭 시버스(Derek Sivers)의 글도 한몫했어요. 이 에세이를 두고 자극이 되는 대화를 많이 나눠 준 앤디 마투샥(Andy Matuschak), 케빈 심러(Kevin Simler), 메이슨 하트먼(Mason Hartman), 로버트 옥스혼(Robert Ochshorn)에게 고마워요. 특히 앤디 마투샥에게는 사려 깊고 즐거운 대화를 많이 나눠 준 데다, 무엇보다 Anki가 단순히 사실을 기억하는 수단이 아니라 이해를 위한 대가의 기술이 될 수 있다는 관점이 얼마나 드문 것인지 짚어 준 데 깊이 감사해요. 마지막으로 Anki에 관한 제 트위터 스레드에 의견을 남겨 준 모든 분께 감사드려요.
부록 1: Anki 학습 시간 분석
Anki 카드 한 장을 20년 동안, 그러니까 사실상 평생 기억하려면 공부에 얼마나 시간을 들여야 하는지 대략 따져 볼게요. 이 분석은 세부 가정에 따라 결과가 크게 달라지니 시간 추정치를 너무 진지하게 받아들이지는 마세요. 그래도 대략 어느 정도 시간이 드는지 감을 잡는 데는 쓸모가 있어요.
카드를 처음 입력하면 Anki는 1분 뒤에, 그다음 10분 뒤에 복습을 요구해요. 이 두 번의 복습이 끝나면 복습 간격이 1일로 훌쩍 늘어나요. 그 뒤로 간격이 늘어나는 비율은 조금씩 다를 수 있지만42, 제 카드는 복습에 성공할 때마다 대체로 약 2.4배씩 늘어나요. 복습에 성공하면 간격이 2.4일, 이어서 2.4 * 2.4 = 6.76일, 하는 식으로 늘어난다는 뜻이에요. 저는 평균적으로 카드 12장 중 1장 정도를 틀리니까, 12번째 복습쯤이면 복습 간격이 약 2.49 = 2,642일까지 늘어나요. 12제곱이 아니라 9제곱을 하는 이유는 카드를 세 번째로 복습할 때가 되어서야 간격이 1일에 이르기 때문이에요.
이 간격을 모두 더하면, 복습에 실패하는 사이의 간격은 보통 12년쯤 된다는 계산이 나와요. 다만 저는 Anki를 아직 그만큼 오래 쓰지 않았으니, 이 추정치는 지나치게 낙관적일 수도 있어요. 실패 사이 간격의 하한은 이렇게 구할 수 있어요. 제 카드의 평균 복습 간격은 이미 1.2년이에요. 간격이 1.2년에 이르려면 그 전에 약 0.9년 동안 복습에 계속 성공해야 하니, 제 카드는 평균적으로 실패 사이에 적어도 2.1년이 걸리는 셈이에요. 하지만 그 카드 대부분이 다음 복습에서 실패하리라고 볼 이유는 없으니 실제 값은 훨씬 클 수도 있어요. 그러니 보수적으로 잡아 실패 사이의 평균 간격을 4년에서 7년 사이로 두기로 해요.
실패 사이의 평균 간격을 4년으로 잡으면 20년 동안 5번 실패하고, 실패 5번 * 주기당 복습 10번 = 50번 복습하니, 모두 50 * 8초 = 400초, 약 7분이 들어요.
평균 간격을 7년으로 잡으면 20년 동안 대략 3번 실패하고, 실패 3번 * 주기당 복습 11번 = 33번 복습하니, 모두 33 * 8초 ≈ 260초, 약 4분이 들어요.
Anki의 모델에서는 한 번 실패하면 복습 간격이 10분으로 되돌아가고, 다시 1일, 2.4일, 하는 식으로 늘어나요. 실제로 써 보면 이건 지나치게 보수적인 것 같아요. 저는 카드 하나를 한두 번 틀리고 나면 대개 감을 잡으니, Anki가 복습 일정을 이렇게 가혹하게 초기화하지 않는 편이 나을 거예요. 복습 일정을 더 잘 짜면 전체 학습 시간이 줄어들 테고, 카드 한 장에 보통 2분 정도만 들여도 된다 해도 저는 놀라지 않을 거예요.
부록 2: Anki로 API 배우기
Anki는 API를 배울 때 쓰기 좋아요. 제게 효과가 있었던 패턴 몇 가지와, 피해야 할 안티패턴 몇 가지를 소개할게요.
시작은 프로젝트에 쓰려고 어떤 API를 배워 보자고 마음먹는 데서부터예요. 그 API를 조금만, 예를 들어 50~100줄 정도의 코드나 아예 1~10줄짜리 코드 조각 몇 개에만 쓰려는 때도 있어요. 그럴 때는 다른 데서 코드 조각을 가져와 고쳐 쓰고 필요할 때마다 문서를 찾아보면서 그때그때 대충 해 나가는 게 가장 나아요.
하지만 프로젝트에서 그 API를 더 본격적으로 쓰리라는 걸 안다고 해 볼게요. 예를 들어 저는 「기술로서의 사고」 (Thought as a Technology)라는 에세이를 쓸 때 3D 그래픽을 쓰는 프로토타입을 몇 개 만들고 싶어서, JavaScript 라이브러리인 three.js의 기초를 배우기로 했어요.
이때 빠지기 쉬운 실패 유형은 “아, API부터 완전히 익혀야겠다”라고 생각하고 튜토리얼이나 문서에 뛰어드는 거예요. 튜토리얼이나 문서를 빠르게 훑어보는 정도가 아니라면 이건 실수예요. 그보다는 제 프로젝트의 핵심 기능과 관련된 일을 하는, 작고 제대로 돌아가는 코드를 찾는 편이 나아요. 프로젝트 전체와 비슷할 필요는 없지만, 비슷한 기능을 한두 개 구현하고 있고 길이가 수십에서 수백 줄 정도면 이상적이에요. 그 코드를 실행되게 만든 다음, 조금씩 고쳐 나가요. 필요한 기능은 조금씩 덧붙이고 필요 없는 부분은 걷어 내면서, 코드를 이해하고 개선하려고 애써요.
나는 아마도 일단 뭔가 돌아가게 만드는 쪽으로 치우치는 편일 것이다… 무언가에 생명을 불어넣을 때 정말 짜릿하다… 일단 살아 움직이기 시작하면 그것이 무엇인지 그것 스스로 말해 주기 시작한다. – 댄 잉걸스(Dan Ingalls)
이 방식의 큰 장점은 한 번에 코드를 1~5줄만 바꾸면 되는데도 목표를 향해 의미 있게 나아가는 게 눈에 보인다는 거예요. 신나는 일이죠. 머신러닝의 비유를 빌리자면, 의미 있는 프로젝트들의 공간에서 경사 하강법 (gradient descent)을 하는 것과 같아요.
물론 이렇게 하는 동안 문서나 StackOverflow 같은 곳에서 끊임없이 뭔가를 찾아보게 돼요. 출발점으로 삼은 코드의 일부를 읽고 이해하기도 하고요. 이걸 전부 Anki 카드로 만들고 싶어지지만, 그건 실수예요. 시간이 너무 많이 들고, 나중에 보면 별 쓸모없는 것까지 지나치게 많이 Anki에 넣게 되거든요. 하지만 어떤 것이 분명히 핵심 개념이거나 자주 다시 쓰리라는 걸 알 때는 Anki에 넣을 만해요. 이렇게 하면 실제로 돌아가는 프로젝트에 쓸 수 있는 지식 기반이 조금씩 쌓여요. 그리고 천천히, 점점 더 나아져요.
프로젝트가 실제로 진척되고 API를 잘 골랐다는 확신이 들면, 그때 튜토리얼을 차근차근 따라 해 볼 만해요. 저는 보통 튜토리얼 몇 개를 빠르게 들춰 보고, 그중 가장 빨리 배울 수 있겠다 싶은 것을 골라요. 그런 다음 그걸 끝까지 따라가요. 이 단계에서는 Anki 카드를 만들긴 하지만 비교적 가볍게 만들어요. 전부 Anki에 넣고 싶은 유혹이 들지만, 그러다 보면 쓸모없는 정보를 잔뜩 외우느라 시간을 엄청나게 쓰게 돼요. 거듭해서 필요하리라는 걸 아는 내용만 Anki에 넣는 편이 훨씬 나아요. 대개는 프로젝트의 지금 단계에서 당장 필요하다는 게 이미 보이는 내용이에요. 첫 번째로 훑을 때는 보수적으로, 적은 양만 Anki에 넣어요. 그리고 튜토리얼을 한 번 끝내면 다시 처음부터 훑으면서, 이번에는 나중에 필요할 것 같은 것을 모두 Anki에 넣어요. 이 두 번째 훑기는 보통 꽤 빨리, 첫 번째보다 빨리 끝날 때도 많아요. 하지만 두 번째에는 맥락을 더 많이 알고 있어서, 무엇을 Anki에 넣을지 판단하는 눈이 더 나아요.
저는 이렇게 계속해 나가요. 튜토리얼과 문서를 읽어 나가는 한편, 코드를 읽다가 마주치는 내용도 살피면서 프로젝트 작업과 Anki 작업을 오가요. 여기서 코드란 다른 사람이 쓴 코드는 물론이고 제가 직접 쓴 코드도 포함해요. 제가 직접 쓴 코드라도 나중에 쓸모가 있을 것 같으면 그 API를 Anki에 넣는 게 의외로 큰 도움이 되더라고요. 제가 썼다고 해서 나중에 기억한다는 보장은 없으니까요!
그러니 튜토리얼과 문서를 곧바로 Anki에 넣기 시작하지는 마세요. 기다렸다가, 프로젝트를 본격적으로 진행하면서 함께 하세요. 고백하자면, 제가 이렇게 조언하는 이유 중 하나는 저 자신도 이 조언을 따르기가 어렵기 때문이에요. 따르지 않았다가 후회하는 일이 거의 매번이에요. 새 프로젝트를 시작하면 “아, 이러이러한 API가 필요하겠네”라고 생각하고는 튜토리얼에 뛰어들어 몇 시간씩 매달려요. 그런데 아무리 애써도 진도가 아주 느리게 나가요. 그러다 제대로 돌아가는 코드를 찾아서 거기서 출발해야 한다는 걸 떠올리고 나면, 곧바로 일이 훨씬 잘 풀려요. 그러고는 다시는 튜토리얼부터 시작하지 않겠다고 다짐하죠. 안타깝게도 실제로는 그 방식에 자꾸 끌려요.
전체 과정은 새 API를 배울 때 흔히 쓰는 ‘해 보면서 배우기’ 방식과 많이 비슷해요. 프로젝트를 하면서 반복을 통해 API를 조금씩 익혀 가는 방식이죠. 가장 큰 차이는 사이사이 가끔 Anki를 쓰면 새 지식이 쌓이는 속도가 상당히 빨라진다는 점이에요.
빠질 수 있는 실패 유형이 하나 있어요. “아, 언젠가 이러이러한 API를 배우고 싶어질지도 모르니, 지금 그 API를 쓰는 프로젝트는 없지만 카드부터 만들어 둬야겠다”라고 생각하는 거예요.
저도 몇 번 해 봤는데, 제 조언은 이래요. 하지 마세요.
이건 에세이 본문에서 설명한 문제의 한 형태예요. 언젠가 쓸 날을 대비해 지식을 비축해 두고 싶은 유혹 말이에요. 프로젝트에서 그 API를 본격적으로 쓰면서 함께 배우면 훨씬 빨리 배워요. API로 새로운 것을 만들다 보면 그 API에서 무엇이 기억할 만큼 중요한지 가려낼 수 있어요. 그리고 이건 추측이지만, 그렇게 하면 뇌에 “이건 정말 중요해”라는 신호를 보내게 되고, 그게 기억에 꽤 큰 도움이 돼요. 그러니 혹시 모를 쓸모를 위해 미리 Anki에 넣고 싶은 마음이 들더라도 부디 참으세요. 그리고 어느새 시작하고 있다면, 멈추세요.
더 까다로운, 부분적인 실패 유형은 결국 ‘고아 API’가 되어 버리는 것을 Anki에 넣는 거예요. 무슨 말이냐면, 프로젝트에 새 API를 쓰면서 그 API의 내용 일부를 Anki에 넣어요. 그러다 프로젝트가 끝났는데 같은 API를 쓰는 다른 프로젝트가 당장은 없어요. 그러면 그 카드에 마음이 잘 붙지 않아요. 반쯤 의식적으로 “내가 왜 이런 쓸데없는 걸 배우고 있지?” 하는 생각이 들어요. API를 한창 쓰던 때만큼 카드가 흥미롭게 느껴지지 않는 거예요.
이건 곤란한 상황이에요. 저는 경험칙 하나를 써요. 그 API를 다시 쓰지 않을 것 같으면 카드가 나올 때 지워요. 하지만 앞으로 1년쯤 안에 그 API를 쓸 것 같으면 덱에 남겨 둬요. 그래도 카드에서 마음이 살짝 멀어지는 건 사실이라 완벽한 해법은 아니에요. 하지만 지금까지 찾은 타협안 중에서는 이게 가장 나아요.
주
-
Vannevar Bush, As We May Think, The Atlantic (1945). ↩
-
예를 들어 다음 글들을 참고하세요. Douglas Engelbart, Augmenting Human Intellect (1962); Ted Nelson, Complex information processing: a file structure for the complex, the changing and the indeterminate (1965); Tim Berners-Lee, Information Management: a Proposal (1989). ↩
-
저는 Anki와 아무런 이해관계가 없어요. 비슷한 시스템으로는 Mnemosyne과 SuperMemo가 있어요. 잠깐 써 본 바로는 Mnemosyne은 Anki와 아주 비슷해요. SuperMemo는 Windows에서만 돌아가서 써 볼 기회가 없었지만, SuperMemo 웹사이트에 실린 글들에서는 영향을 받았어요.
Anki를 향한 제 열의를 공정한 척하는 점잖은 겉모습 뒤에 숨기지는 않을게요. Anki는 제 삶에서 큰 부분을 차지해요. 그래도 한계가 많고, 글 곳곳에서 그중 몇 가지를 언급할 거예요. ↩ -
이런 식의 분석은 그원 브랜원(Gwern Branwen)이 간격 반복 (spaced repetition)을 검토한 글에서 처음 봤어요. Gwern Branwen, Spaced-Repetition. 브랜원의 수치는 제 것보다 조금 더 낙관적이지만(10분이 아니라 5분이라는 경험칙에 이르러요) 대체로 일치해요. 브랜원의 분석은 다시 다음 글의 분석에 바탕을 두고 있어요. Piotr Wozniak, Theoretical aspects of spaced repetition in learning. ↩
-
데스크톱 클라이언트는 무료지만, 모바일 클라이언트는 이 글을 쓰는 시점에 25달러예요. 많은 사람이 “너무 비싸다”며 망설여요. 제 경우에는 그 가치가 25달러보다 몇 자릿수는 더 컸어요. 모바일 Anki는 적당한 가격대 식당에서 먹는 한 끼보다 제게 훨씬 값어치가 있는 게 분명해요. ↩
-
나중에 찰스 디킨스(Charles Dickens)의 『두 도시 이야기』 (A Tale of Two Cities)로 실험을 해 봤어요. 정말 본문 전체를 외울 수 있을지 알아보려는 거였죠. 몇 주 뒤 저는 가능하긴 하지만 시간을 들일 가치는 없다고 결론 내렸어요. 그래서 카드를 전부 지웠어요. 지우고 나서 흥미로운 일이 일어났어요. 책의 첫 몇 문장이 제 기억에서 점점 희미해져서, 지금은 단편밖에 남아 있지 않아요. 좋은 책 한 권을 통째로 외우면 어떤 영향이 있을지 가끔 궁금해요. 제 언어와 글쓰기에 큰 영향을 준다 해도 놀랍지 않을 거예요. ↩
-
David Silver, Aja Huang, Chris J. Maddison, Arthur Guez 외, Mastering the game of Go with deep neural networks and tree search, Nature (2016). ↩
-
Michael Nielsen, Is AlphaGo Really Such a Big Deal?, Quanta (2016). ↩
-
Michael A. Nielsen, “Neural Networks and Deep Learning”, Determination Press (2015). ↩
-
알파고 제로는 David Silver, Julian Schrittwieser, Karen Simonyan, Ioannis Antonoglou 외, Mastering the game of Go without human knowledge, Nature (2017)를 보세요. 알파제로는 David Silver, Thomas Hubert, Julian Schrittwieser, Ioannis Antonoglou 외, Mastering Chess and Shogi by Self-Play with a General Reinforcement Learning Algorithm (2017)를 보세요. ↩
-
즉, Anki에 넣는다는 뜻이에요. Ankification 같은 변형도 쓸모가 있어요. ↩
-
Benjamin F. Jones and Bruce A. Weinberg, Age Dynamics in Scientific Creativity, Proceedings of the National Academy of Sciences (2011). ↩
-
두 사람의 훌륭한 책 『독서의 기술』 (How to Read a Book)에서: Mortimer J. Adler and Charles van Doren, “How to Read a Book: The Classic Guide to Intelligent Reading” (1972) ↩
-
벨라 볼로바시(Béla Bollobás)가 엮은 “Littlewood’s miscellany”(1986)에서. ↩
-
운동 기술과 문제 해결에는 얼마나 잘 쓰일 수 있을지 궁금해요. 두 영역 모두 아직 Anki를 써 보지 않았어요. ↩
-
개인 기억 시스템으로 읽는 법에 관한 글은 많은 사람이 썼어요. 제 생각에 특히 자극을 준 글은 이거예요. 표트르 보즈니악(Piotr Wozniak), Incremental Reading. ↩
-
유용한 패턴 목록이 하나 더 있어요. Piotr Wozniak, Effective learning: Twenty rules of formulating knowledge. ↩
-
더 원자적으로 만들려면 첫 번째 질문을 “링크를 만드는 Unix 명령은?”과 “소프트 링크를 만들 때
ln명령에 주는 옵션은?”으로 나눌 수도 있어요. 실제로는ln이 링크를 만드는 명령이라는 걸 몇 년 전부터 알고 있었기 때문에 그럴 필요가 없었어요. ↩ -
점진적인 이유는, 바뀐 맥락에 맞춰 질문을 다시 써야 할 때가 있어서예요. 예를 들어 제 Emacs 덱과 Unix 명령줄 덱에는 “단어를 어떻게 지우는가?” 같은 아주 비슷한 질문이 있었어요. 이런 질문은 이를테면 “Emacs에서 단어를 어떻게 지우는가?”로 다시 써야 해요. (그런데 저처럼 Emacs를 오래 쓴 사람에게는 이상한 질문으로 보일 수도 있어요. 사실 저는 Emacs에서 단어를 지우는 방식을 바꾸는 데 Anki를 활용했고, 그래서 이 주제의 Anki 질문이 있는 거예요. 저는 이런 식으로 Emacs 작업 흐름을 여러 군데 개선했어요.) ↩
-
MedicalSchoolAnki 서브레딧을 참고하세요. 어떤 덱이 가장 좋은지, 그 덱을 어떻게 쓰는지에 관한 논의가 자주 올라오고, 목적별로 쓰기 좋은 덱의 정전 목록도 계속 바뀌며 정리돼 있어요. 다음 논문도 참고하세요. Michael Hart-Matyas et al, Twelve tips for medical students to establish a collaborative flashcard project, Medical Teacher (2018). ↩
-
재미있으면서도 유익한 개관으로는 다음 책이 있어요. Joshua Foer, “Moonwalking with Einstein” (2011) (『1년 만에 기억력 천재가 된 남자』 ). ↩
-
Richard P. Feynman, “What Do You Care What Other People Think? Further Adventures of a Curious Character” (1989) (『남이야 뭐라 하건!』 ). ↩
-
사실 그 목적이라면 그림을 보여 주고 제목이 무엇인지 묻는 질문이 더 나아요. ↩
-
커트 보니것(Kurt Vonnegut)에게 양해를 구하며 빌려 온 말이에요. 보니것은 이렇게 썼어요. “우리는 우리가 무엇인 척하는 바로 그것이 되므로, 무엇인 척할지 조심해야 한다.” ↩
-
친구들은 가끔 많은 책이 쓸데없이 부풀린 에세이라고 불평해요. 어쩌면 그런 부풀림에도 이점이 있을지 몰라요. 독자가 책을 읽는 데 몇 주가 걸리니 Anki 같은 간격 반복이 저절로 일어나거든요. 요점을 외우는 방법으로는 비효율적일 수 있지만, 책을 전혀 기억하지 못하는 것보다는 나아요. ↩
-
코드 스멜(code smell)에 빗대어, 리팩터링이 필요할지도 모른다는 신호를 “질문 스멜”이라고 부를 수 있어요. 예/아니요 구조는 질문 스멜의 한 예예요. ↩
-
Alan Kay and Adele Goldberg, Personal Dynamic Media (1977). ↩
-
Frank N. Dempster, The Spacing Effect: A Case Study in the Failure to Apply the Results of Psychological Research (1988). ↩
-
Robert A. Bjork, Memory and Metamemory Considerations in the Training of Human Beings (1994). ↩
-
예를 들어 Herbert A. Simon, How Big is a Chunk?, Science (1974)와 Adriaan de Groot, Thought and Choice in Chess, Amsterdam University Press (2008, 1965년판 재간행)를 보세요. ↩
-
George A. Miller, The Magical Number Seven, Plus or Minus Two: Some Limits on our Capacity for Processing Information (1956). ↩
-
이 상관관계에 대한 리뷰는 Phillip L. Ackerman, Margaret E. Beier, and Mary O. Boyle, Working Memory and Intelligence: The Same or Different Constructs? Psychological Bulletin (2006)에서 볼 수 있어요. ↩
-
이를 판단하려면 이런 청크가 정확히 어떻게 생겨나는지 이해하는 게 도움이 될 거예요. 그 부분은 아직 잘 밝혀지지 않은 듯해요. 장기 기억뿐 아니라 상당한 분석과 문제 해결도 관여한다고 해도 놀랍지 않을 거예요. ↩
-
Hermann Ebbinghaus, Memory: A Contribution to Experimental Psychology (1885). 에빙하우스의 결과를 최근에 재현한 연구는 다음에서 볼 수 있어요. Jaap M. J. Murre and Joeri Dros, Replication and Analysis of Ebbinghaus’ Forgetting Curve (2015). ↩
-
이 확장은T5 많이 연구됐지만, 확장을 예측하는 상세한 모델을 세운 연구는 의외로 거의 없어요. 예외로는 다음 논문이 있어요. Burr Settles and Brendan Meeder, A Trainable Spaced Repetition Model for Language Learning (2016). 이 논문은 온라인 언어 학습 플랫폼 Duolingo에서 학생들의 기억이 쇠퇴하는 속도를 예측하는 회귀 모델을 세워요. 그 결과 쇠퇴 속도를 더 잘 예측했을 뿐 아니라 Duolingo 학생들의 참여도도 높아졌어요. ↩
-
많은 실험이 집중 연습과 분산 연습의 효과를 참가자들이 어떻게 인식하는지도 평가하려고 해요. 놀랍게도 참가자들은 집중 연습이 더 효과적이라고 믿는 경우가 많아요. 분산 연습이 집중 연습보다 꾸준히 더 나은 성과를 내는데도 말이에요. ↩
-
여기서 그런 검토를 하기보다는, 입문하기에 좋은 리뷰 몇 편을 소개할게요. Benedict Carey의 책 “How We Learn”(2015)은 대중적인 수준의 좋은 입문서예요. 분산 연습 문헌을 다룬 유용한 리뷰로는 Cepeda et al, Distributed Practice in Verbal Recall Tasks: A Review and Quantitative Synthesis (2006), 그리고 Gwern Branwen, Spaced-Repetition이 있어요. ↩
-
William James, “The Principles of Psychology” (1890). ↩
-
Axel Oehrn, Experimentelle Studien zur Individualpsychologie (1895). ↩
-
다음을 참고하세요. Piotr Wozniak, Repetition spacing algorithm used in SuperMemo 2002 through SuperMemo 2006. Anki는 SM-2 알고리즘을 써요. ↩
-
외부인이 이런 말을 하면 HCI 커뮤니티에서 환영받지 못하리라는 걸 알아요. 그렇다고 입을 다문다고 나아지는 것도 없다고 생각해요. CHI 학회 같은 커뮤니티의 주요 행사를 보면, 압도적으로 많은 논문이 초기 증강 연구에 비해 소심해 보여요. 관례적인 정적 논문(인터랙티브한 JavaScript와 HTML도 아닌 pdf)을 출판하는 일이 여전히 이 분야의 중심이라는 것만 봐도 알 만해요. ↩
-
Anki에서는 카드를 복습할 때 일반적인 “알맞음”(Good, 맞혔다는 뜻)이나 “다시”(Again, 틀렸다는 뜻) 말고도 카드가 “쉬움”(Easy)이었는지 “어려움”(Hard)이었는지 지정할 수 있기 때문이에요. 이 추가 선택지에 따라 간격이 늘어나는 정확한 비율이 달라져요. 실제로 저는 거의 언제나 “알맞음”을 고르거나, 카드를 틀렸다고 Anki에 알려요. ↩
역자 주
-
젊은 숙녀를 위한 그림 입문서: 닐 스티븐슨(Neal Stephenson)의 SF 소설 『다이아몬드 시대』 (The Diamond Age, 1995)에 나오는 인터랙티브 교재 「A Young Lady’s Illustrated Primer」에서 따온 제목이에요. 소설 속 입문서는 읽는 아이에게 맞춰 스스로 이야기를 바꿔 가며 가르치는 책이라, 학습을 돕는 도구를 상상할 때 자주 불려 나와요. 원문의 이 에세이 링크는 지금 열리지 않아서 번역문에는 링크를 달지 않았어요. ↩
-
신토피컬 독서(syntopical reading): 애들러와 밴 도렌이 『독서의 기술』 에서 독서의 가장 높은 단계로 꼽은 읽기예요. 한 주제에 관한 여러 책을 함께 읽으면서 서로 비교하고, 어느 책에도 그대로 쓰여 있지 않은 논점과 질문을 스스로 세워 가는 방식이에요. 책의 용어는 syntopical인데, 원문은 syntopic이라고 썼어요. ↩
-
놀리다(joshing): 영어 josh는 ‘놀리다, 농담하다’라는 뜻의 동사예요. 포어의 이름 Josh와 소리가 같아서, 쿡은 이름을 이 동사의 이미지로 바꿔 기억해요. 성 Foer도 같은 식으로 소리가 비슷한 four(넷)로 바꿨어요. ↩
-
해밀턴과 하루노부: 영어권 독자를 전제로 한 예예요. 영어권 사람에게 리처드 해밀턴은 흔히 듣는 이름과 비슷하게 들리고, 스즈키 하루노부는 낯선 이름이에요. 한국어 독자라면 거꾸로 익숙한 한국 이름과 낯선 외국 이름을 떠올리면 같은 차이를 느낄 수 있어요. ↩
-
이 확장: 원문의 this expansion이 무엇을 가리키는지 원문에서도 분명하지 않아요. 문맥으로 보면, 바로 뒤 단락에서 다루는 현상, 곧 회상을 거듭할수록 기억이 쇠퇴하는 데 걸리는 시간이 늘어나는 현상을 가리키는 것으로 보여요. ↩
저자 소개: 마이클 닐슨(Michael Nielsen)은 양자 컴퓨팅 교과서의 공저자이자 오픈 사이언스 운동을 이끈 과학자로, 생각을 돕는 도구를 연구해요.
참고: 이 글은 마이클 닐슨이 Y Combinator Research에 있던 2018년 7월 augmentingcognition.com에 게시한 에세이를 번역했어요. 원문은 CC BY-NC 3.0(크리에이티브 커먼즈 저작자표시-비영리 3.0 Unported) 라이선스로 공개되어 있어서, 누구나 자유롭게 복제하고 공유하고 이를 바탕으로 새 작업을 할 수 있지만 판매할 수는 없어요. 상업적으로 쓰고 싶다면 저자에게 연락하라고 원문은 안내해요.
원문: Augmenting Long-term Memory - Michael Nielsen, Y Combinator Research (2018년 7월, 최종 수정 2018년 7월 4일). 학술 인용 시 저자가 요청한 표기: Michael A. Nielsen, “Augmenting Long-term Memory”, http://augmentingcognition.com/ltm.html, 2018
생성: Claude (Anthropic)